D
V4.1-Flash-1017 · V4-Pro-0813
DeepSeek
DeepSeek · סיןלפי היצרן: שיפור בהיגיון, קוד ומשימות סוכן, עם תשובות קצרות וזולות יותר. הקשר של 1M טוקנים ב-API.
מדריך מעשי · עדכני ל-16.11.2026
הבדיחה בצד, המודלים הסיניים הפתוחים הם מהטובים והזולים שיש היום. במדריך הזה תנסו את DeepSeek, Qwen, Kimi, GLM ו-MiniMax בחינם: בצ'אט הרשמי, דרך API, ועל המחשב שלכם בלי אינטרנט. כולל טבלת השוואה, בודק חומרה, ומה קורה עם המידע שאתם מקלידים.
הבדיחה והאמת
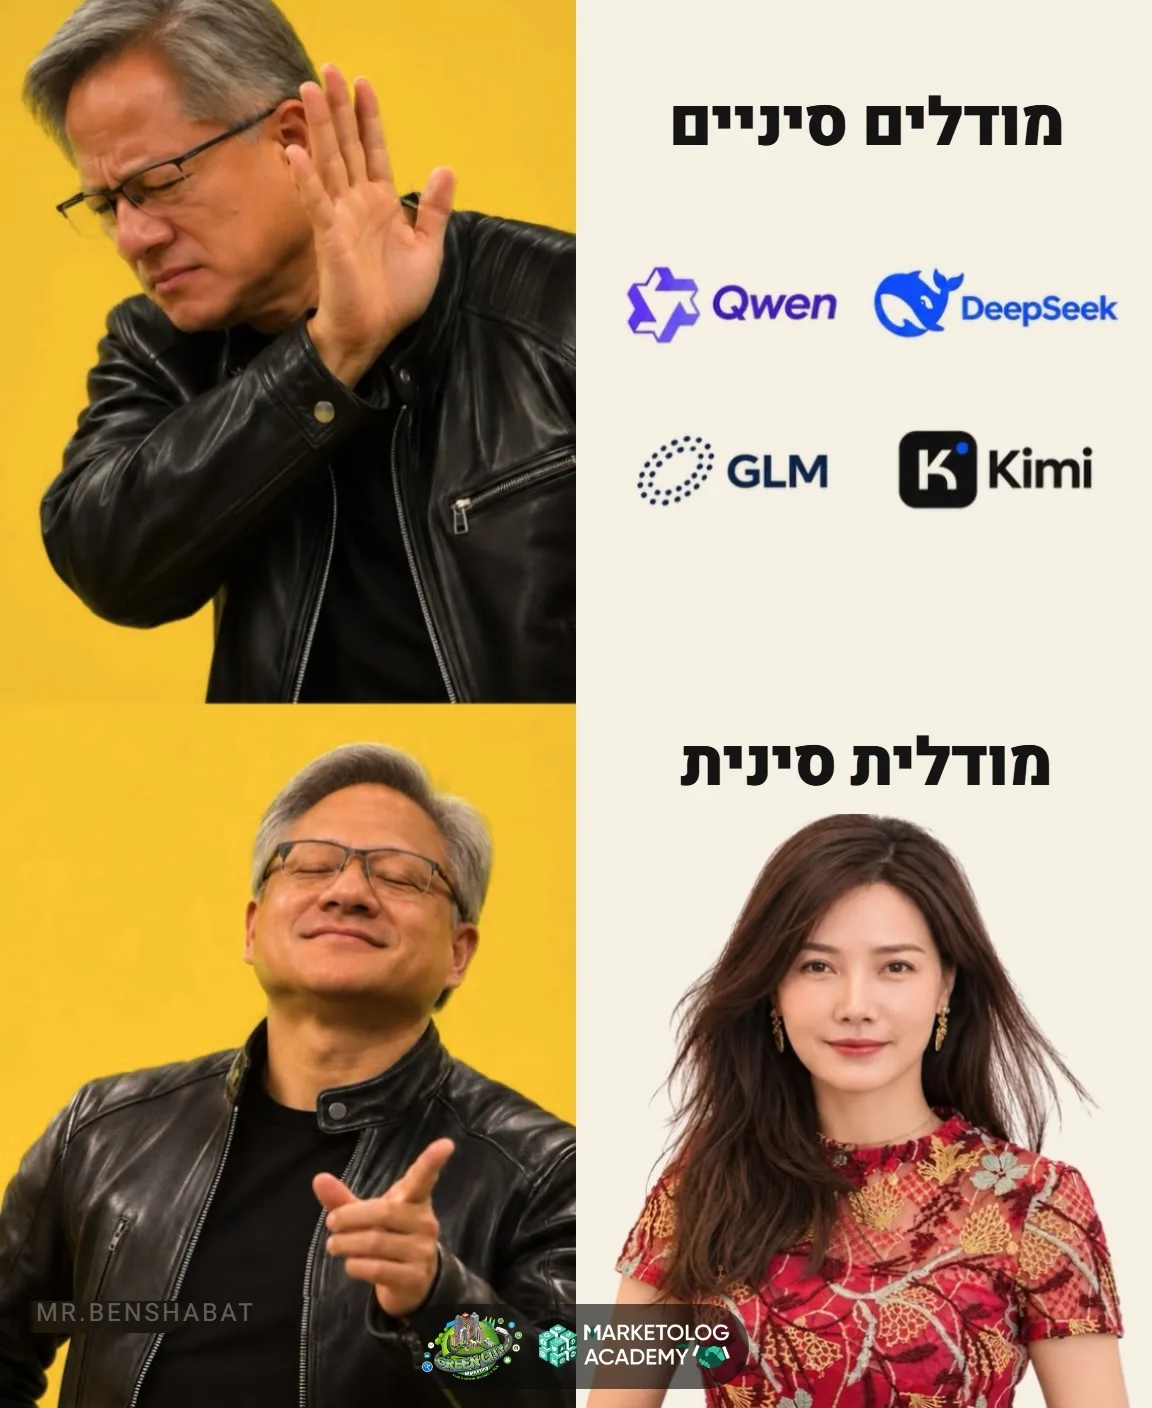
במם, "מודלים סיניים" זה Qwen, DeepSeek, GLM ו-Kimi, ו"מודלית סינית" זה... משהו אחר. אבל מאחורי הצחוק יש סיבה אמיתית לשים לב: רוב המודלים האלה פתוחי משקלות (open-weight). מורידים את המודל עצמו, מריצים איפה שרוצים, ולפעמים משלמים פחות מסנט על אלף מילים.
הסגל, נובמבר 2026
השמות של המם, עם הגרסאות העדכניות שבדקנו ב-Hugging Face, Ollama ו-OpenRouter ב-16.11.2026. ה"חוזקות" הן מה שהיצרן עצמו כותב בכרטיס המודל, לא מבחן שלנו.
לפי היצרן: שיפור בהיגיון, קוד ומשימות סוכן, עם תשובות קצרות וזולות יותר. הקשר של 1M טוקנים ב-API.
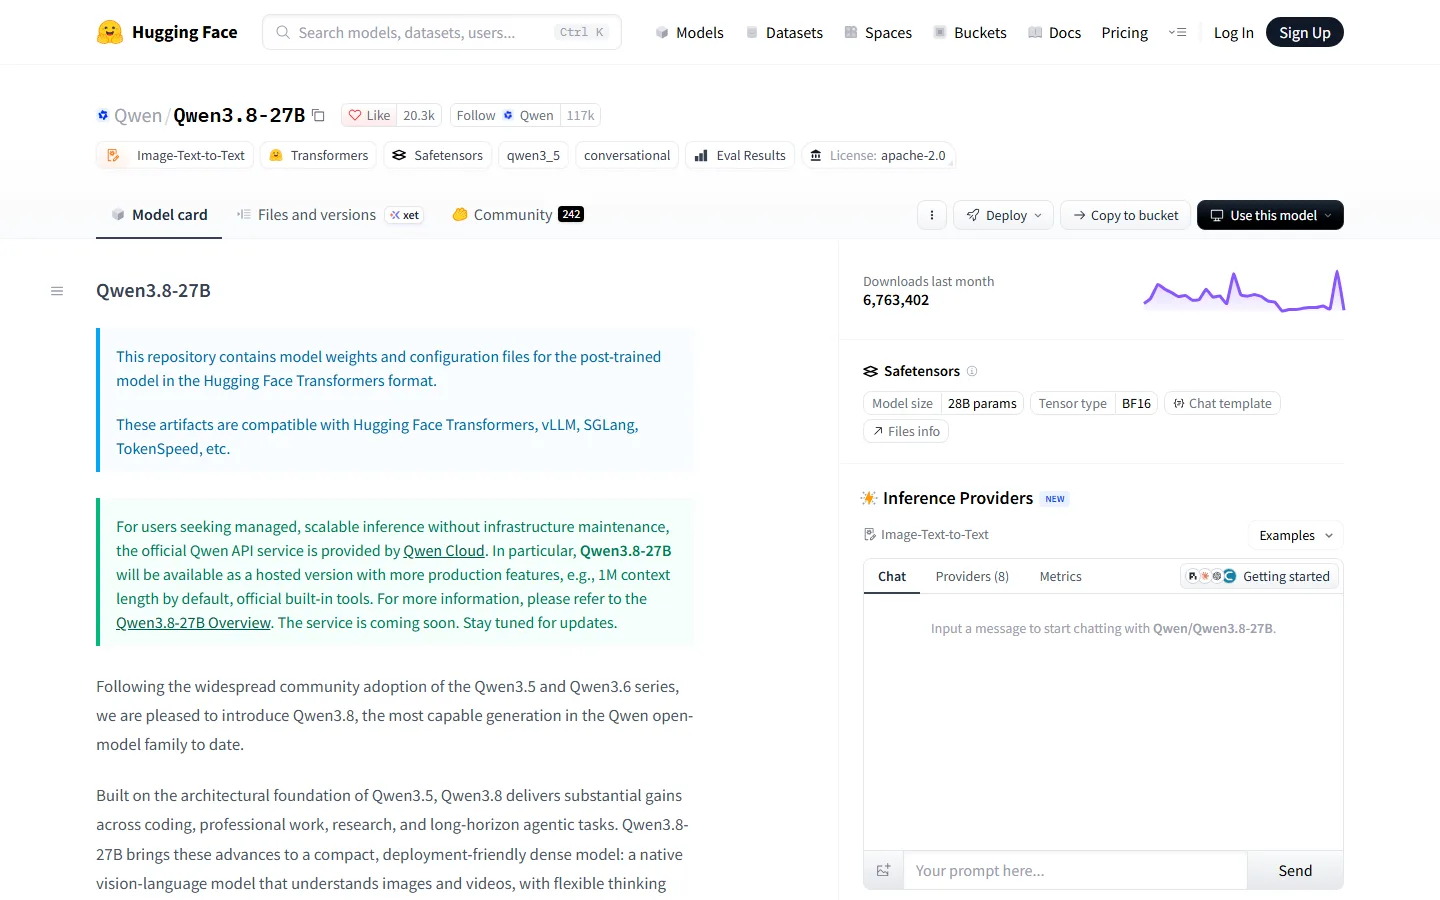
לפי היצרן: Qwen3.8-27B הוא מודל "קומפקטי וידידותי לפריסה" שמבין גם תמונות ווידאו. זה השחקן שהכי קל להריץ בבית.
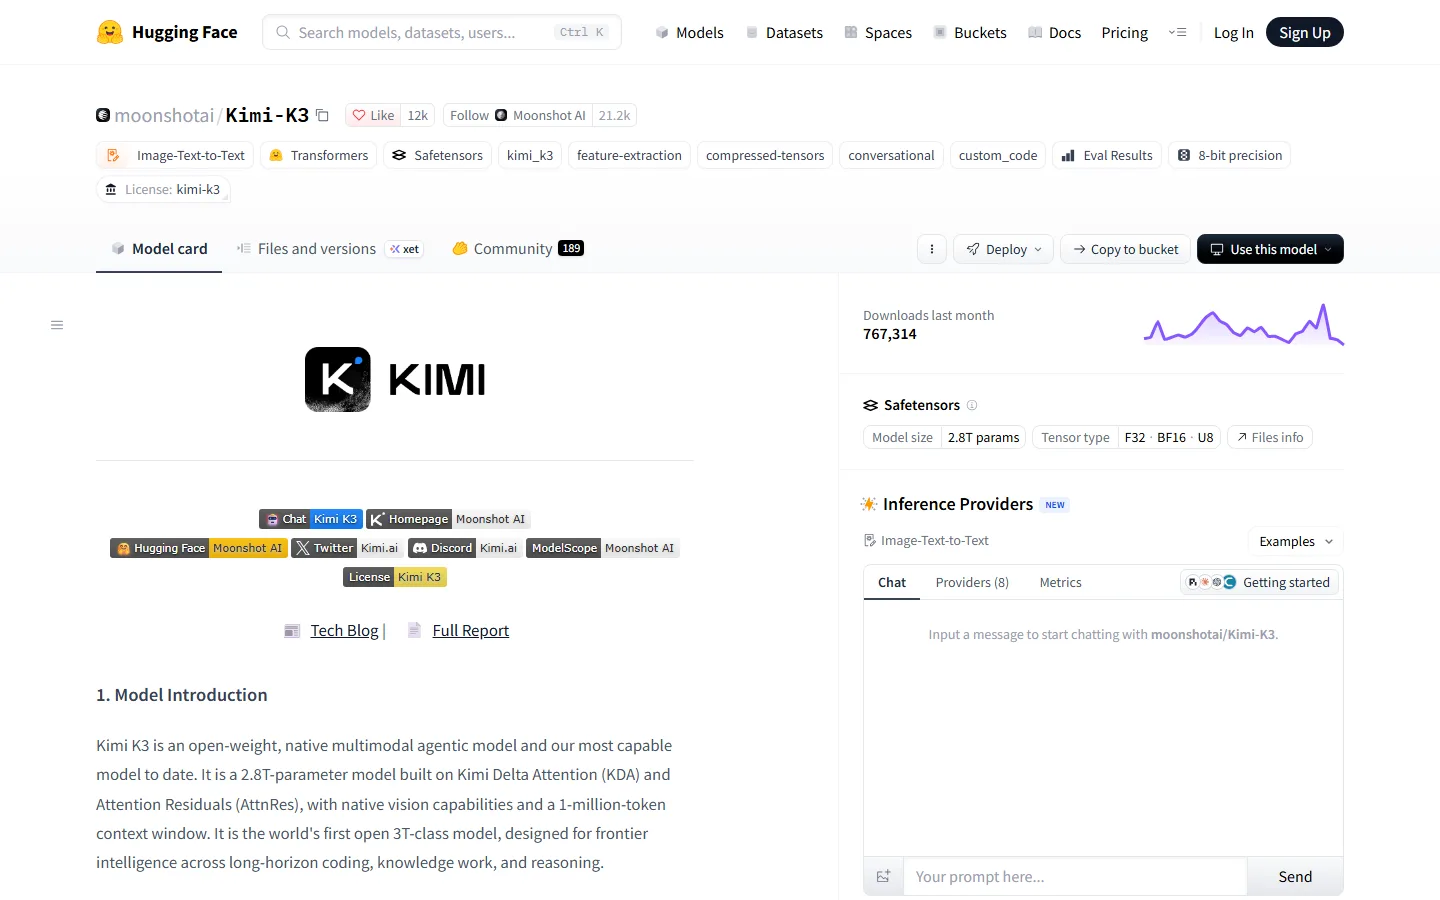
לפי היצרן: מודל סוכני מולטימודלי בגודל 2.8T פרמטרים, הקשר 1M. באתר: Agent Swarm שמפעיל עד 300 תת-סוכנים.
לפי היצרן: GLM-5.3 "המודל הפתוח החזק ביותר לקוד", עם קפיצה במשימות ארוכות. גרסת Flash ב-MIT וזולה מאוד.
לפי היצרן: MoE של כ-428B (23B פעילים), טקסט+תמונה+וידאו כקלט, הקשר עד 1M, מכוון לקוד וסוכנים.
לא במם, אבל שווה הכרה: MIT, ויש גרסת 9B שרצה על לפטופ (6.6GB ב-Ollama). לפי היצרן: קוד וסוכנים.
הזירה
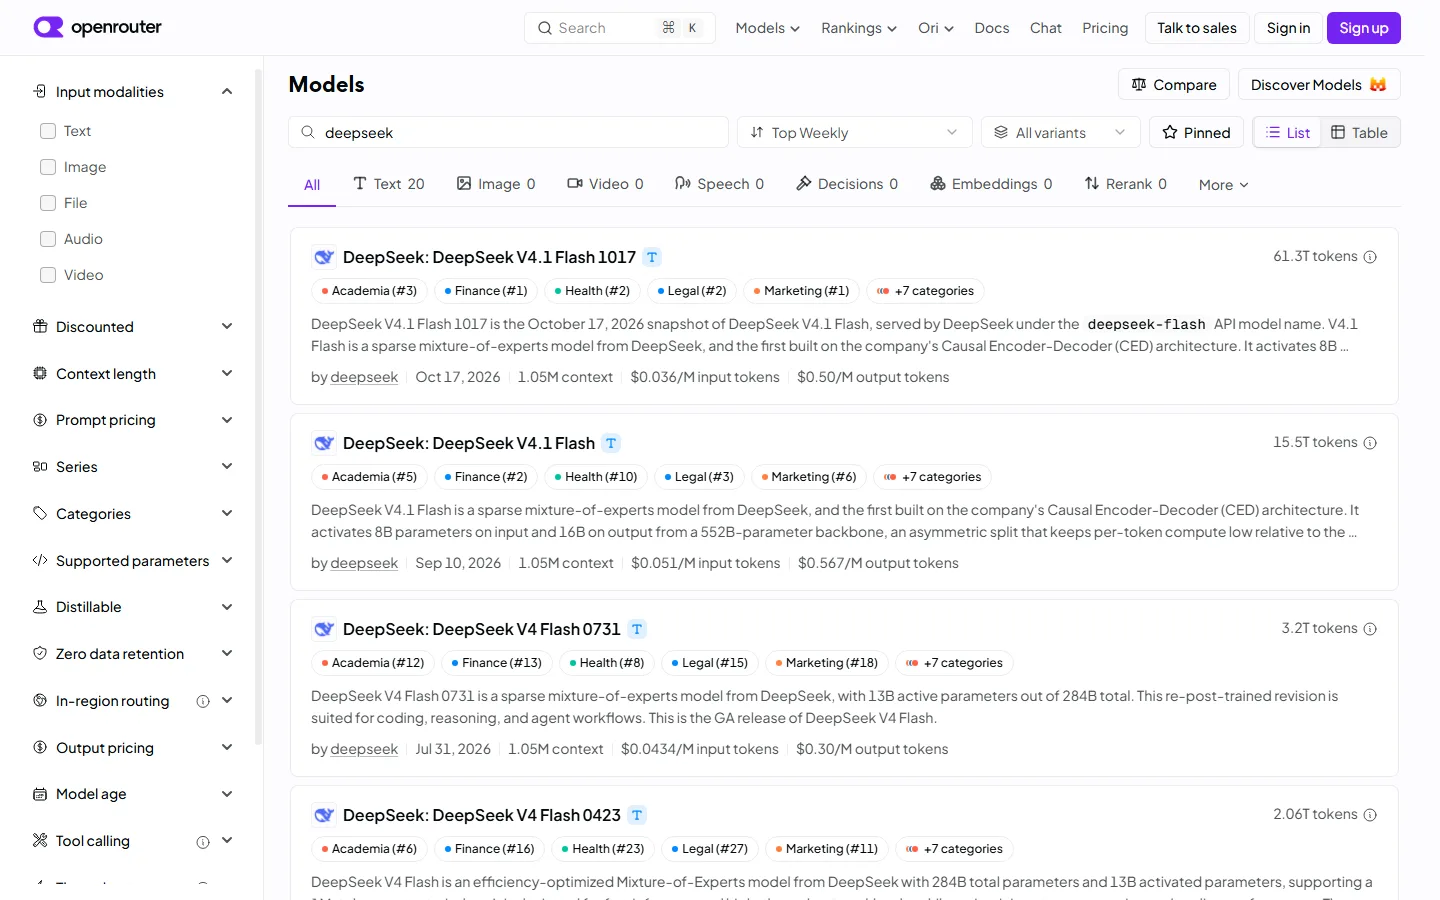
בחרו מה חשוב לכם והטבלה תסנן. מחירים מ-API הציבורי של OpenRouter, רישיון ופרמטרים מ-Hugging Face, נכון ל-16.11.2026. ❤ = לייקים ב-Hugging Face (מדד פופולריות, לא איכות).
"בתנאים" = רישיון שמתיר הרבה, אבל מוסיף דרישות: Kimi K3 ו-GLM-5.3 מוסיפים תנאים לחברות שמוכרות גישה למודל עם הכנסות גבוהות (Kimi: מעל $20M, GLM: מעל $10B). MiniMax M3.1-Flash: שימוש מסחרי מחייב קרדיט "Built with MiniMax" והודעה ל-MiniMax. קראו את קובץ ה-LICENSE לפני שימוש עסקי.
מפת העבודה
מהקל לכבד: צ'אט בדפדפן, מבחן עברית, API, Hugging Face, ובסוף הרצה מקומית שלא יוצאת מהמחשב.
לכל יצרן יש צ'אט בדפדפן, בסגנון ChatGPT. השימוש הבסיסי חינמי, עם הגבלות שימוש. ברוב המקרים צריך להתחבר (גוגל או אימייל) כדי לשמור היסטוריה או להשתמש יותר. ההתחברות שלכם, אנחנו לא התחברנו.
אין טבלת בנצ'מרק אמינה לעברית, אז עושים מבחן קטן לבד. מדביקים את אותם פרומפטים בכל צ'אט ומשווים. ראיתם בשלב 5: מודל קטן מקומי נכשל בעברית באופן מביך, אז זה מבחן שווה.
כתוב כיתוב קצר לאינסטגרם לבית קפה שכונתי בחיפה שפותח השבוע ארוחות בוקר. עברית ישראלית טבעית, בלי תרגומית, עד 3 שורות, עם קריאה לפעולה אחת.
בודק: עברית טבעית, הבנה של הקשר מקומי.
הסבר במשפט אחד לתייר מה הכוונה במשפטים: "יאללה, סגרנו", "זה לא בדיוק אמבטיה", "אני על זה". אחר כך תן לכל אחד מקבילה באנגלית.
בודק: סלנג, ניבים, והאם המודל ממציא כשהוא לא יודע.
סכם ב-5 נקודות מה ההבדל בין עוסק פטור לעוסק מורשה בישראל. אם אתה לא בטוח בפרט מסוים (למשל תקרת המחזור), כתוב במפורש שאתה לא בטוח ושצריך לבדוק באתר רשות המסים.
בודק: דיוק, והאם המודל מודה בחוסר ודאות.
כרטיס ציון · המחשה להדפסה
OpenRouter נותן מפתח אחד שעובד מול מאות מודלים, כולל כל השחקנים מהזירה. נרשמים (ההרשמה שלכם), יוצרים API key, ומשתמשים בקוד בפורמט של OpenAI.
baidu/ernie-5.5-flash-preview:free ו-inclusionai/ling-3.2-flash:free. השחקנים הגדולים בתשלום, אבל זול מאוד: GLM-5.3-Flash עולה $0.04 למיליון טוקנים נכנסים. הרשימה החינמית משתנה, אז בדקו שוב.import requests
models = requests.get("https://openrouter.ai/api/v1/models").json()["data"]
free = [m["id"] for m in models
if float(m["pricing"]["prompt"]) == 0 and float(m["pricing"]["completion"]) == 0]
print(len(models), "models,", len(free), "free")
print("\n".join(free))from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key="sk-or-...") # your key
r = client.chat.completions.create(
model="z-ai/glm-5.3-flash", # or deepseek/deepseek-v4.1-flash, qwen/qwen3.8-27b
messages=[{"role": "user", "content": "כתוב 3 רעיונות לפוסט לבית קפה בחיפה"}],
)
print(r.choices[0].message.content)מגבלות למודלים החינמיים (:free) לפי הדוקומנטציה: 20 בקשות לדקה, ו-50 ביום אם קניתם פחות מ-10 קרדיטים, או 1,000 ביום אם קניתם לפחות 10.
$ python check_free.py
470 models, 17 free
inclusionai/ling-3.2-flash:free
baidu/ernie-5.5-flash-preview:free
nvidia/nemotron-3.5-lightning:free
google/gemma-4-31b-it:free
...
openrouter/free
# no deepseek / qwen / kimi / glm / minimax :free today
Hugging Face הוא "חנות האפליקציות" של המודלים. לפני שמשתמשים במודל ברצינות, נכנסים לדף שלו ובודקים 4 דברים:
טריק: Ollama יודע להריץ ישירות קבצי GGUF מ-Hugging Face:
ollama run hf.co/<user>/<repo-GGUF>
זו הדרך היחידה שבה המידע לא יוצא מהמחשב. מתקינים את Ollama, מורידים מודל פעם אחת, ומשם הוא עובד גם בלי חיבור.
# Windows (PowerShell)
irm https://ollama.com/install.ps1 | iex
# macOS / Linux
curl -fsSL https://ollama.com/install.sh | sh
ollama run qwen3.5:4b      # 3.3GB  · almost any laptop
ollama run qwen3.5:9b      # 6.6GB  · 8GB+ GPU or 16GB Mac
ollama run mimo-v2.6:9b    # 6.6GB  · Xiaomi, MIT
ollama run qwen3.8:27b     # 18GB   · 24GB GPU or 32GB+ Mac
הרצנו את זה בעצמנו על לפטופ עם RTX 5080 Laptop (16GB VRAM), Ollama 0.40.16. ההרצה הראשונה כוללת טעינה (אצלנו כדקה), השנייה כמעט מיידית. ושימו לב לעברית:
curl http://localhost:11434/v1/chat/completions -H "Content-Type: application/json" -d '{
  "model": "qwen3.5:4b",
  "messages": [{"role": "user", "content": "In one sentence: what is an open-weight model?"}]
}'$ ollama run qwen3.5:4b --think=false --verbose "כתוב 3 רעיונות קצרים לפוסט אינסטגרם לבית קפה בתל אביב. שורה אחת לכל רעיון." הקומנטריק של תל אביב מתחיל לרדת והמראה הפשוט הופך למיוחד כאן. תפוחי אדמה חמוצים טריים יחד עם מנה משלושה סוגי בשר – קלאסיקה לאורך השבוע. מקום להרגיש בבית תוך דקות, מהירה ומרובה צבעים לקצת אנרגיה נכונה. total duration: 1m56.875016s load duration: 1m4.6496592s eval rate: 44.18 tokens/s
$ ollama run qwen3.5:4b --think=false --verbose "Give me 3 short Instagram post ideas for a coffee shop in Tel Aviv. One line each."
☕ Start your morning with the best views and vibes on Jaffa Road. 🌆
🥯 Fresh pastries + locally roasted beans = perfect Tel Aviv breakfast. 🇮🇱
Join us for live music & artisan coffee while the city wakes up. 🎸
total duration:  611.0897ms
eval rate:       128.40 tokens/s
{
  "object": "chat.completion",
  "model": "qwen3.5:4b",
  "choices": [{ "message": { "role": "assistant",
    "content": "An open-weight model is an artificial intelligence system where the underlying mathematical architecture and trained parameter values are publicly released, allowing anyone to inspect, modify, and deploy it without needing proprietary access or special licensing." },
    "finish_reason": "stop" }],
  "usage": { "prompt_tokens": 23, "completion_tokens": 41, "total_tokens": 64 }
}לא אוהבים טרמינל? LM Studio מוריד ומריץ מודלים פתוחים עם חלון צ'אט רגיל.
qwen3.8 או mimo ובוחרים גרסה שמתאימה לזיכרון.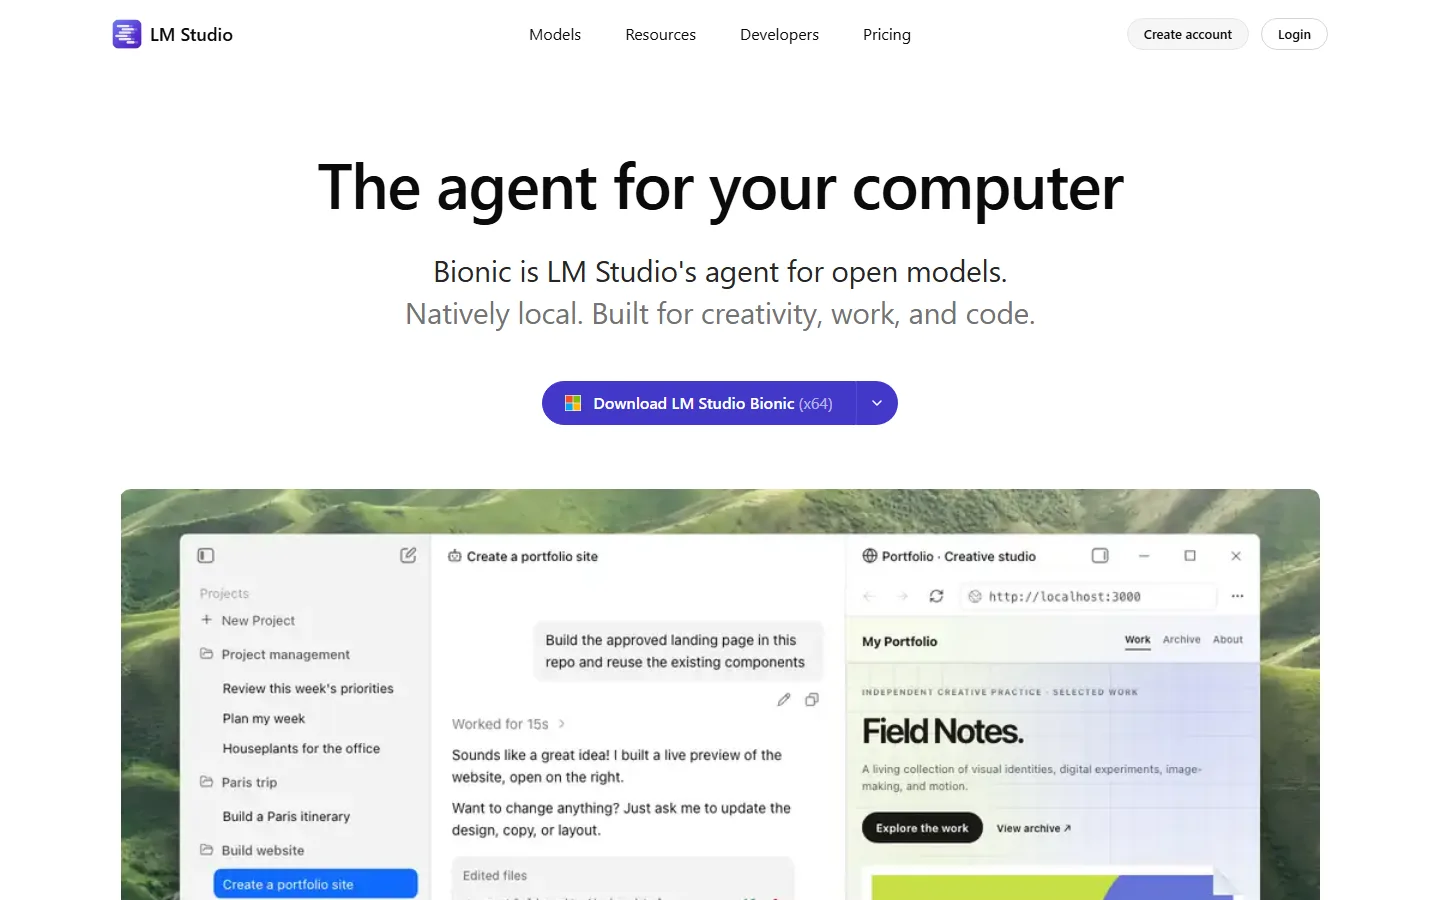
בודק חומרה
הגדלים מספריית Ollama (גרסאות ברירת המחדל, דחוסות). כלל אצבע: המודל צריך להיכנס לזיכרון של כרטיס המסך, עם קצת מקום פנוי. ב-Mac הזיכרון משותף, אז בערך 70% ממנו זמין למודל.
איפה רואים? Windows: מנהל המשימות ← ביצועים ← GPU ← "זיכרון GPU ייעודי". Mac: תפריט התפוח ← אודות ה-Mac ← זיכרון.
DeepSeek V4.x, Kimi K3, GLM-5.3 ו-MiniMax M3.x הם מאות GB עד טרה-בייטים. ב-Ollama הם מופיעים רק עם תגית cloud, כלומר רצים בשרתים של Ollama ולא אצלכם (חשבון ותמחור לפי Ollama). אותם מנסים בצ'אט הרשמי או ב-API.
פרטיות, בכנות
זה נכון לכל צ'אט AI, לא רק לסיניים. אבל כדאי לדעת את הפרטים.
מדיניות הפרטיות של DeepSeek כותבת שהיא מעבדת ושומרת מידע ב"People's Republic of China", ושהקלטים משמשים "to train and improve our technology". יש זכות לבקש opt-out מאימון במייל ל-privacy@deepseek.com. אצל השאר: קראו את מדיניות הפרטיות של כל שירות לפני שימוש עסקי.
כשקוראים למודל פתוח דרך OpenRouter, הוא יכול לרוץ אצל ספק אירוח שאינו היצרן. בדף המודלים יש סינון Zero data retention. בדקו מי הספק ומה מדיניות הנתונים שלו.
Ollama או LM Studio עם מודל שהורד: הטקסט נשאר אצלכם. לחומר רגיש (לקוחות, חוזים, רפואי) זו הדרך שלנו. המחיר: מודל קטן וחלש יותר.
תקלות נפוצות
כי אין גרסה מקומית. בספרייה מופיע רק kimi-k3:cloud, שרץ בענן של Ollama. למחשב הביתי: Qwen או MiMo.
הוא לא נכנס לזיכרון הגרפי ורץ על המעבד. ירדו גודל (9b ← 4b), או סגרו תוכנות כבדות. ההרצה הראשונה תמיד איטית יותר.
מודל קטן מדי. עלו ל-9B ומעלה, או השתמשו בצ'אט הרשמי. ובקשו במפורש "עברית ישראלית טבעית".
נגמרה מכסת הבקשות החינמיות (50 ביום בלי קרדיטים). חכו, או טענו קרדיט.
קורה. מודלים לא תמיד יודעים מי הם. מה שקובע הוא איזה מודל בחרתם בממשק או בקוד.
בצ'אטים הרשמיים של יצרנים סיניים יש סינון תוכן בנושאים מסוימים. למחקר כזה, נסו מודל אחר.
מהפוסט
"כולם משווים בין מודלי AI סיניים. ג'נסן כבר בחר את המועדף עליו 😂"
שאלות נפוצות
תלוי במשימה, ולכן בנינו את הזירה ואת מבחן העברית. בנצ'מרקים שהיצרנים מפרסמים, כל אחד מנצח במבחנים שהוא בחר. המבחן שלכם על המשימות שלכם שווה יותר.
הצ'אטים הרשמיים: שימוש בסיסי חינם עם הגבלות. Ollama ו-LM Studio: חינם, החומרה שלכם. OpenRouter: היום אין גרסה חינמית לחמשת השחקנים מהמם, אבל המחירים נמוכים מאוד.
MIT ו-Apache 2.0 (DeepSeek, Qwen3.8-27B, GLM-5.3-Flash, MiMo) מתירים כמעט הכל. Kimi K3 ו-GLM-5.3 מתירים, עם תנאים לחברות גדולות שמוכרות גישה למודל. MiniMax M3.1-Flash דורש קרדיט והודעה לשימוש מסחרי. זה לא ייעוץ משפטי: קראו את ה-LICENSE.
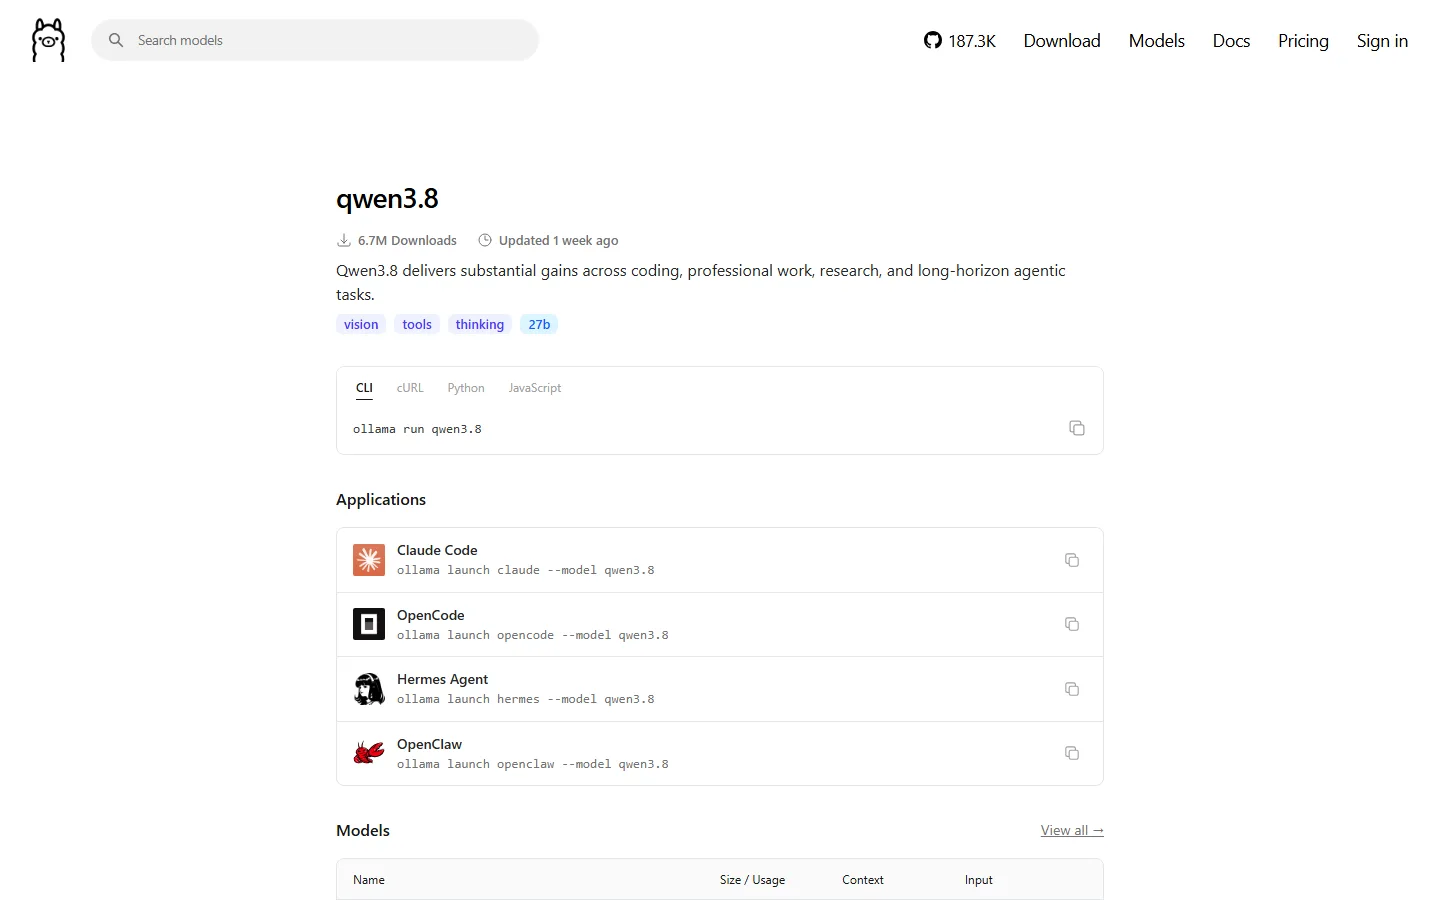
בספריית Ollama, בדף של qwen3.8, מופיעות פקודות ollama launch לכלים כמו Claude Code, OpenCode ו-OpenClaw. לא בדקנו את זה במדריך הזה.
עם 8GB זיכרון תוכלו להריץ qwen3.5:2b או qwen3.5:4b. זה מספיק לסיכומים קצרים באנגלית ולניסוי. למשימות אמיתיות בעברית, הצ'אט הרשמי עדיף.
זה מם. החלק המעניין במדריך הוא המודלים, לא המודלית 🙂
רוצים עוד מדריכים כאלה?
כל שבוע: כלי AI, אוטומציות ושיווק דיגיטלי, מוסברים צעד אחר צעד (גם כשהפוסט הוא מם).