מפתח API חינמי של Google, סקריפט Python אחד, ו-Claude שקורא את התוצאות. במדריך הזה תבנו את הסורק בעצמכם, תדרגו סרטונים לפי כמה הם "מנצחים" את גודל הערוץ שלהם, ותהפכו את הדפוס לערוץ משלכם.
LIVE SAMPLEscan · 2026-11-16 · 6 queries · last 7 days · >20 min
videos scanned69
ranked (≥5k views)45
channels36
top views / sub494×
views ≥ 2× subscribersother videosviews = subs
הרעיון
לא מנחשים נישה. מודדים אותה.
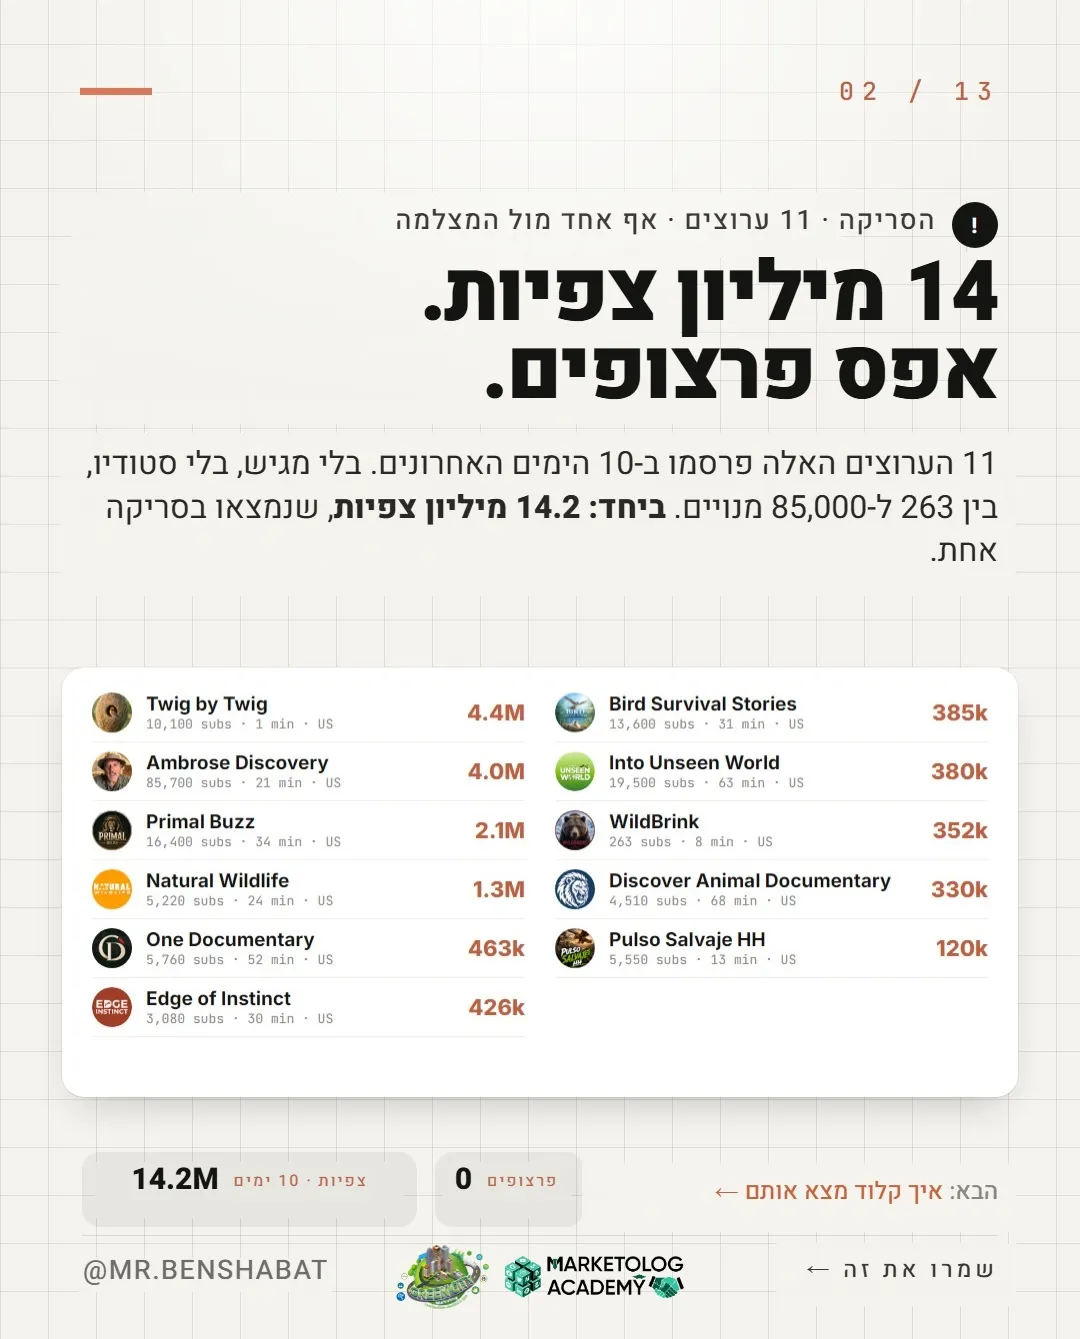
לפי הפוסט, Claude סרק 1,283 סרטונים ב-4 דקות ומצא 11 ערוצים בלי אף אחד מול המצלמה, שביחד עשו 14 מיליון צפיות ב-10 ימים. את הרשימה הספציפית שלהם לא יכולנו לאמת. את השיטה כן: בנינו את הסורק, הרצנו סריקה אמיתית, והתוצאה למטה. הרעיון פשוט: סרטון עם מיליון צפיות בערוץ ענק לא מלמד כלום. סרטון עם 76 אלף צפיות בערוץ של 155 מנויים מלמד שהנושא, הכותרת והפורמט עובדים, גם בלי קהל קיים.
views ÷ subsהמדד הראשי: כמה פעמים הסרטון גדול מהערוץ
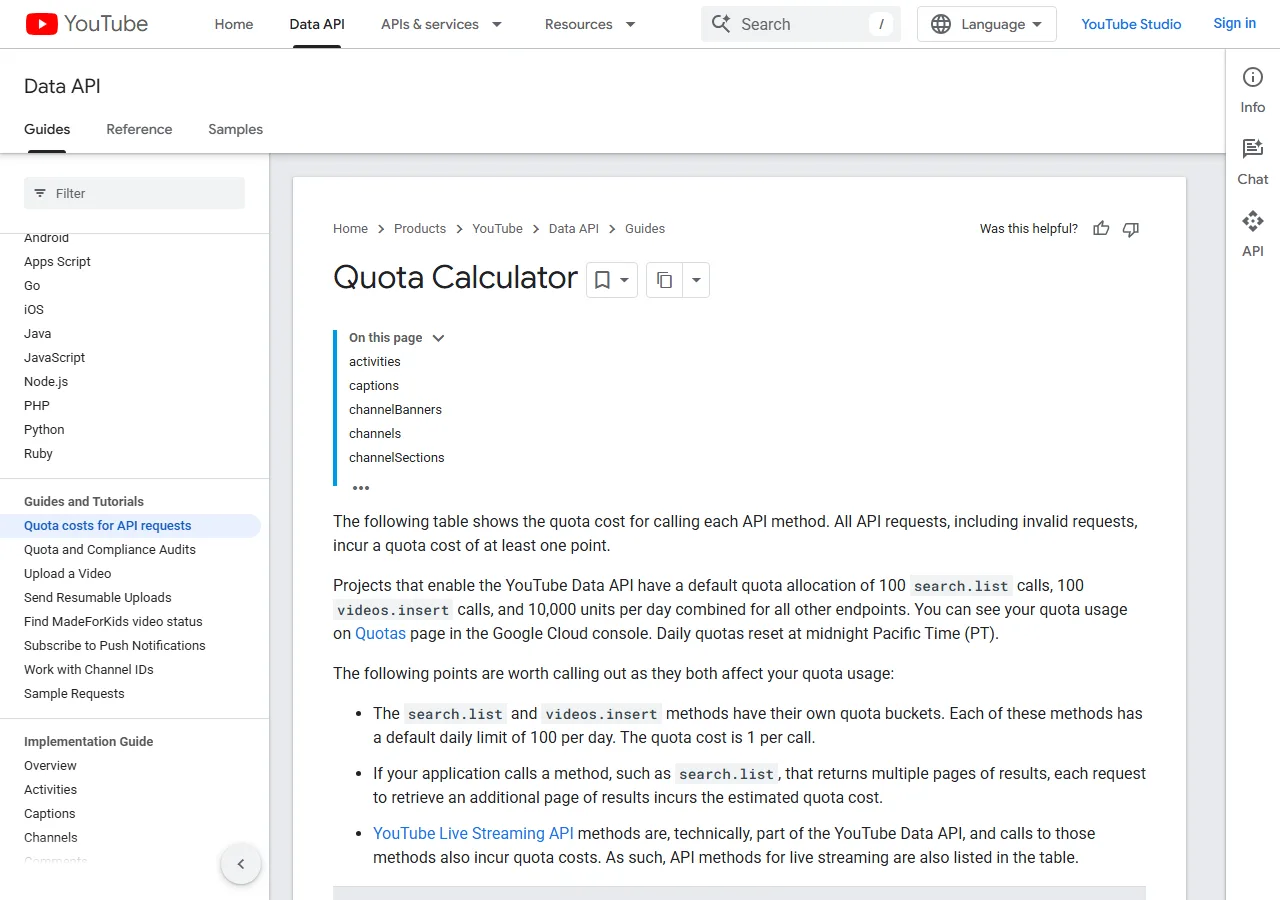
10,000יחידות quota ביום, חינם, לכל הקריאות חוץ מחיפוש
100קריאות חיפוש ביום (באקט נפרד), כל אחת עד 50 תוצאות
$0עלות ה-API עד המכסה. אין צורך בכרטיס אשראי למפתח
לפני שמתחילים
מה צריך
חשבון Google
חינם
לכניסה ל-Google Cloud console וליצירת פרויקט ומפתח API.
Python 3.9+
חינם
הסורק משתמש רק בספרייה הסטנדרטית. אין pip install. מורידים מ-python.org.
Claude
Pro ל-Code
לניתוח ולתסריטים מספיק claude.ai. ל-Claude Code (טרמינל, כמו בפוסט) צריך Pro: $17 לחודש בחיוב שנתי או $20 חודשי. התוכנית החינמית לא כוללת אותו.
מחשב רגיל
GPU אופציונלי
הסריקה רצה על כל מחשב. רק אם תבחרו לייצר וידאו מקומית (Wan 2.2) צריך כרטיס NVIDIA.
בספריית ה-API (API Library) מחפשים YouTube Data API v3 ולוחצים Enable.
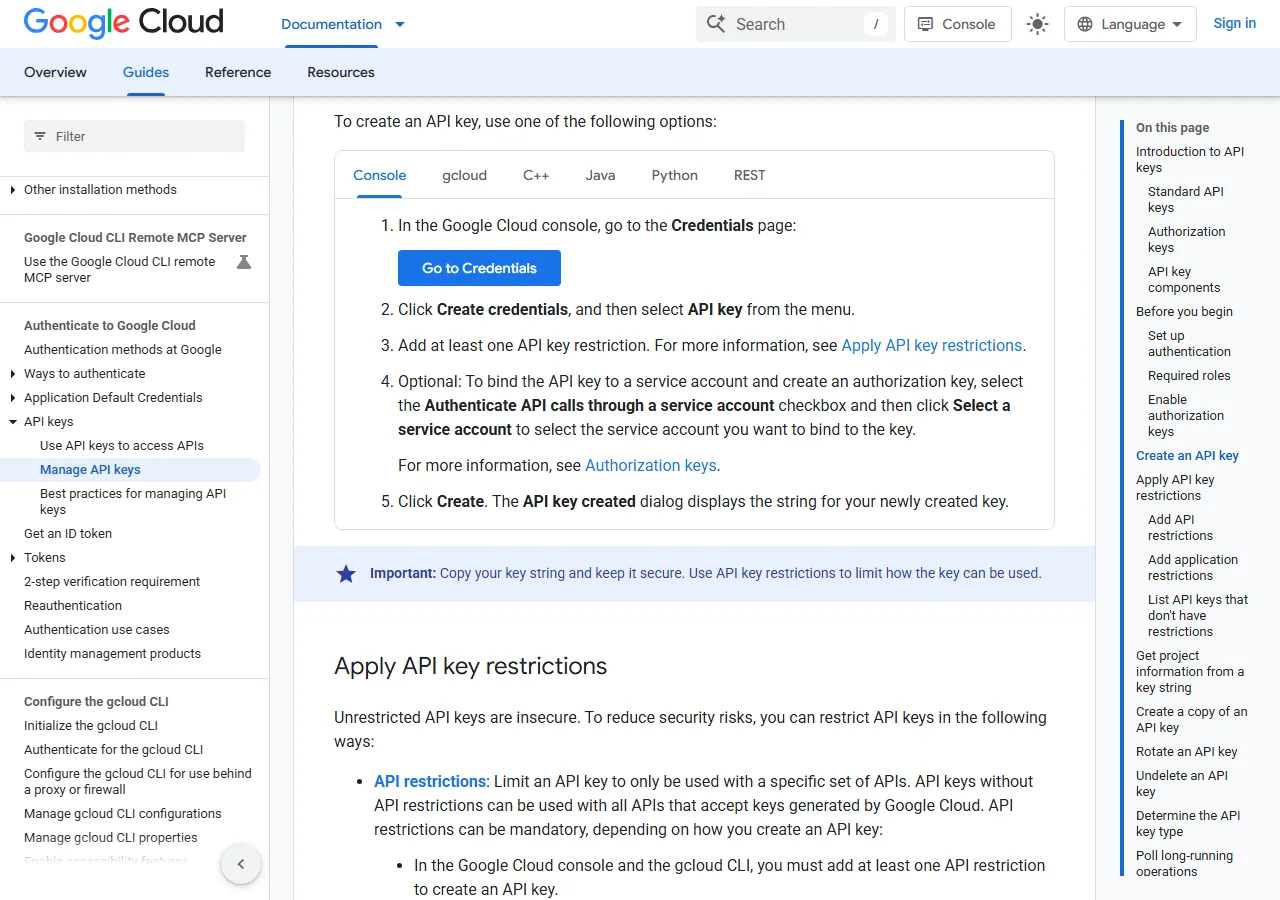
עוברים לעמוד Credentials, לוחצים Create credentials ובוחרים API key.
מגבילים את המפתח: ב-API restrictions בוחרים רק את YouTube Data API v3 ושומרים (Save).
מי שמשתמש ב-gcloud יכול להפעיל את ה-API בפקודה אחת (זו הפקודה שמופיעה גם בפוסט):
gcloud (אופציונלי)
gcloud services enable youtube.googleapis.com
ושומרים את המפתח במשתנה סביבה, לא בתוך הקוד:
PowerShell (Windows)
$env:YT_API_KEY = "PASTE_YOUR_KEY_HERE"
Mac / Linux
export YT_API_KEY="PASTE_YOUR_KEY_HERE"
מפתח API הוא כמו סיסמה. לא מדביקים אותו בצ'אט, בפוסט, בצילום מסך או ב-GitHub. מפתח שדלף? מוחקים ויוצרים חדש באותו עמוד Credentials. מפתח API מתאים רק לנתונים ציבוריים, וזה כל מה שהסורק צריך.
מה יוצא מהשלב?מפתח פעיל, מוגבל ל-YouTube Data API v3, שמור במשתנה YT_API_KEY.
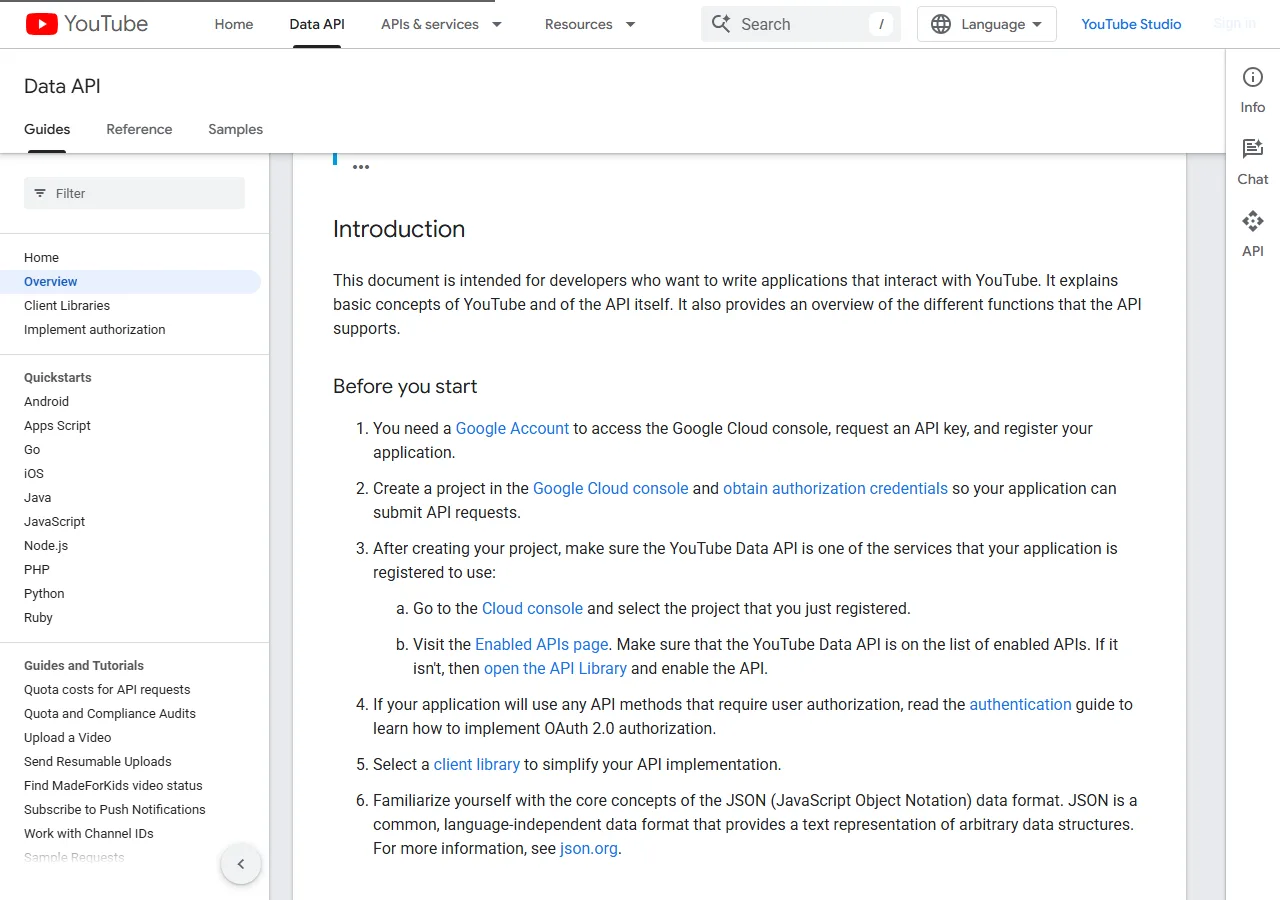
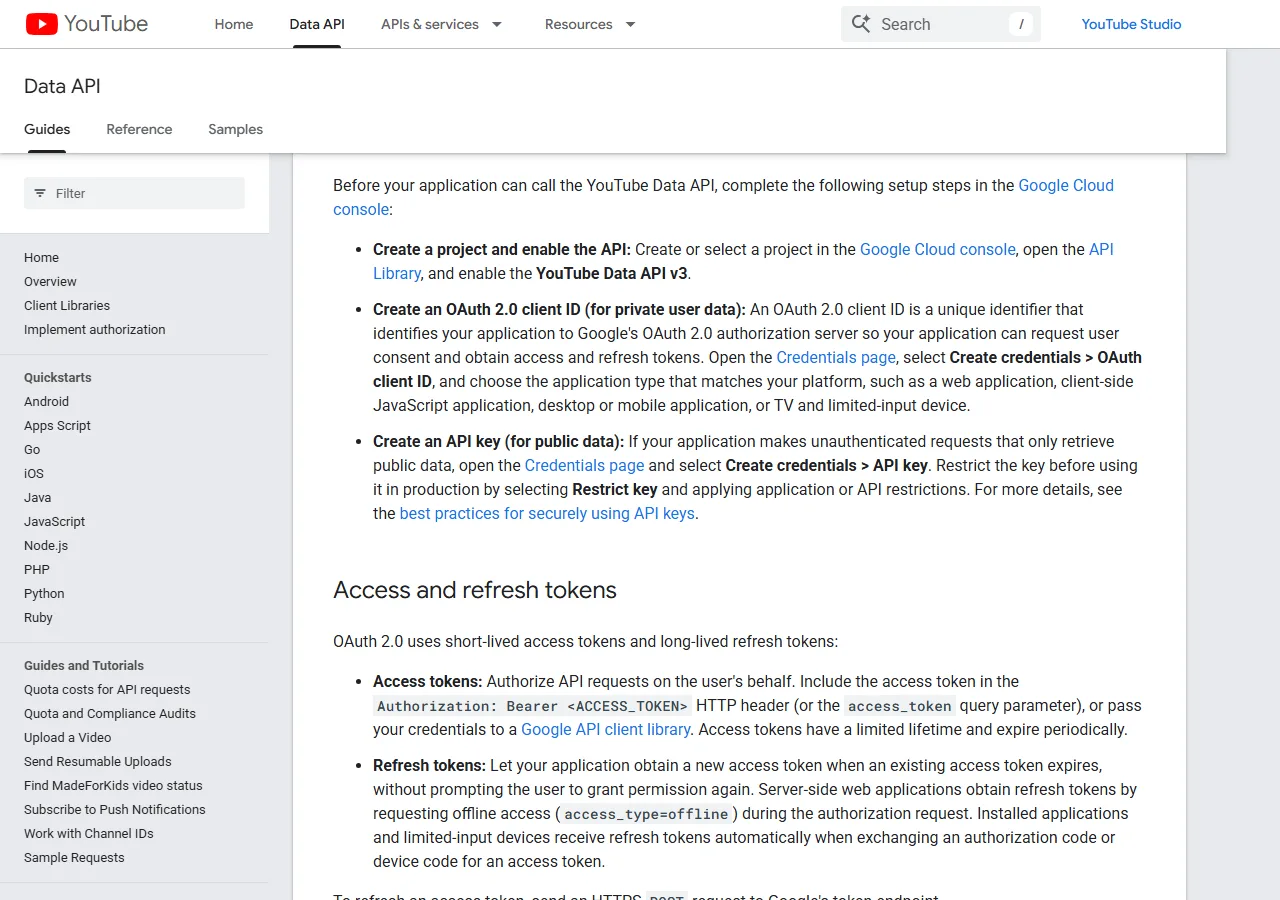
developers.google.com/youtube/v3/getting-started
התיעוד הרשמי: יוצרים פרויקט, ובודקים ש-YouTube Data API נמצא ב-Enabled APIs (צילום אמיתי).
זה הסורק המלא. הוא מחפש לפי רשימת נושאים, מושך לכל סרטון צפיות, אורך ותאריך, מושך לכל ערוץ את מספר המנויים, ומדרג. שמרו אותו כ-yt_scanner.py (או הורידו את הקובץ) והריצו:
#!/usr/bin/env python3
"""
yt_scanner.py - find YouTube videos that are beating their channel's size.

Uses the official YouTube Data API v3 with a free API key (public data only).
No pip install needed: standard library only (Python 3.9+).

  1. Put your key in an environment variable:
       Windows PowerShell:  $env:YT_API_KEY = "AIza..."
       macOS / Linux:       export YT_API_KEY="AIza..."
  2. Run:
       python yt_scanner.py                       # default queries, last 10 days, long videos
       python yt_scanner.py --days 7 --duration medium --median
       python yt_scanner.py --queries "ocean mysteries,lost civilizations" --pages 2
       python yt_scanner.py --from-json saved.json  # re-rank data you already collected
       python yt_scanner.py --max-subs 20000 --min-views 50000 --sort views_per_sub

Ranking columns:
  views/day   = views / days since upload
  views/sub   = views / channel subscribers   (a small channel with a huge video = a pattern worth studying)
  x_median    = views / median views of the channel's last 10 uploads   (only with --median)

Quota (default project, Nov 2026): 100 search.list calls per day in their own bucket,
plus 10,000 units per day for everything else (videos.list / channels.list / playlistItems.list = 1 unit per call).
This script prints how much it used. Quotas reset at midnight Pacific Time.
"""
import argparse, csv, json, os, re, statistics, sys, time
import urllib.parse, urllib.request, urllib.error
from datetime import datetime, timedelta, timezone

API = "https://www.googleapis.com/youtube/v3/"
DEFAULT_QUERIES = [
    "wildlife documentary", "animal documentary", "ocean mysteries", "deep sea creatures",
    "lost civilizations", "ancient history documentary", "survival story", "nature documentary",
]
USED = {"search": 0, "units": 0}


def call(endpoint, key, **params):
    """GET one API endpoint and return parsed JSON. Counts quota as it goes."""
    params["key"] = key
    url = API + endpoint + "?" + urllib.parse.urlencode(params)
    for attempt in range(3):
        try:
            with urllib.request.urlopen(url, timeout=30) as r:
                data = json.loads(r.read().decode("utf-8"))
            if endpoint == "search":
                USED["search"] += 1
            else:
                USED["units"] += 1
            return data
        except urllib.error.HTTPError as e:
            body = e.read().decode("utf-8", "ignore")
            if e.code == 403 and "quota" in body.lower():
                sys.exit("Quota exhausted for today. It resets at midnight Pacific Time. Try fewer --pages or queries.")
            if e.code in (400, 403):
                sys.exit(f"API error {e.code}: {body[:400]}\nCheck that the key is right and YouTube Data API v3 is enabled.")
            if attempt == 2:
                raise
            time.sleep(2 * (attempt + 1))
        except urllib.error.URLError:
            if attempt == 2:
                raise
            time.sleep(2 * (attempt + 1))


def chunks(items, n=50):
    for i in range(0, len(items), n):
        yield items[i:i + n]


def iso_duration_to_seconds(d):
    m = re.fullmatch(r"P(?:(\d+)D)?T?(?:(\d+)H)?(?:(\d+)M)?(?:(\d+)S)?", d or "")
    if not m:
        return 0
    days, h, mi, s = (int(x or 0) for x in m.groups())
    return days * 86400 + h * 3600 + mi * 60 + s


def search_ids(key, queries, days, pages, duration, region, lang):
    after = (datetime.now(timezone.utc) - timedelta(days=days)).strftime("%Y-%m-%dT%H:%M:%SZ")
    ids = []
    for q in queries:
        token, got = None, 0
        for _ in range(pages):
            p = dict(part="snippet", q=q, type="video", order="viewCount", publishedAfter=after,
                     maxResults=50, videoDuration=duration, regionCode=region, relevanceLanguage=lang)
            if token:
                p["pageToken"] = token
            data = call("search", key, **p)
            new = [it["id"]["videoId"] for it in data.get("items", []) if it.get("id", {}).get("videoId")]
            ids += new
            got += len(new)
            token = data.get("nextPageToken")
            if not token:
                break
        print(f"  search  {q:<32} {got:>4} results", file=sys.stderr)
    return list(dict.fromkeys(ids))  # de-duplicate, keep order


def fetch_videos(key, ids):
    out = {}
    for batch in chunks(ids):
        data = call("videos", key, part="snippet,statistics,contentDetails", id=",".join(batch))
        for v in data.get("items", []):
            st, sn = v.get("statistics", {}), v.get("snippet", {})
            out[v["id"]] = {
                "video_id": v["id"],
                "title": sn.get("title", ""),
                "channel_id": sn.get("channelId", ""),
                "channel": sn.get("channelTitle", ""),
                "published": sn.get("publishedAt", ""),
                "views": int(st.get("viewCount", 0) or 0),
                "likes": int(st.get("likeCount", 0) or 0),
                "comments": int(st.get("commentCount", 0) or 0),
                "duration_min": round(iso_duration_to_seconds(v.get("contentDetails", {}).get("duration")) / 60, 1),
            }
    return out


def fetch_channels(key, channel_ids):
    out = {}
    for batch in chunks(channel_ids):
        data = call("channels", key, part="statistics,contentDetails", id=",".join(batch))
        for c in data.get("items", []):
            st = c.get("statistics", {})
            out[c["id"]] = {
                "subs": None if st.get("hiddenSubscriberCount") else int(st.get("subscriberCount", 0) or 0),
                "channel_videos": int(st.get("videoCount", 0) or 0),
                "uploads": c.get("contentDetails", {}).get("relatedPlaylists", {}).get("uploads"),
            }
    return out


def channel_medians(key, channels, last_n=10):
    """Median views of each channel's last N uploads (1 playlistItems call per channel + batched videos.list)."""
    recent = {}
    for cid, c in channels.items():
        if not c.get("uploads"):
            continue
        try:
            data = call("playlistItems", key, part="contentDetails", playlistId=c["uploads"], maxResults=last_n)
        except urllib.error.HTTPError:
            continue
        recent[cid] = [it["contentDetails"]["videoId"] for it in data.get("items", [])]
    all_ids = [v for ids in recent.values() for v in ids]
    views = {}
    for batch in chunks(all_ids):
        data = call("videos", key, part="statistics", id=",".join(batch))
        for v in data.get("items", []):
            views[v["id"]] = int(v.get("statistics", {}).get("viewCount", 0) or 0)
    return {cid: statistics.median([views[v] for v in ids if v in views]) for cid, ids in recent.items()
            if any(v in views for v in ids)}


def rank(rows, sort_key="views_per_sub", now=None):
    now = now or datetime.now(timezone.utc)
    for r in rows:
        pub = datetime.fromisoformat(r["published"].replace("Z", "+00:00"))
        age = max((now - pub).total_seconds() / 86400, 0.25)  # avoid dividing by ~0 for brand-new uploads
        r["age_days"] = round(age, 1)
        r["views_per_day"] = round(r["views"] / age)
        subs = r.get("subs")
        r["views_per_sub"] = round(r["views"] / max(subs, 1), 1) if subs is not None else None
        med = r.get("channel_median")
        r["x_median"] = round(r["views"] / max(med, 1), 1) if med else None
        r["url"] = "https://www.youtube.com/watch?v=" + r["video_id"]
    rows = [r for r in rows if r.get(sort_key) is not None]
    return sorted(rows, key=lambda r: r[sort_key], reverse=True)


def short(n):
    if n is None:
        return "-"
    for unit, size in (("M", 1e6), ("k", 1e3)):
        if n >= size:
            return f"{n / size:.1f}{unit}"
    return str(int(n))


def print_table(rows, top, sort_key):
    print(f"\nTop {min(top, len(rows))} by {sort_key}  (of {len(rows)} videos)\n")
    print(f"{'#':>3} {'score':>8} {'views':>7} {'subs':>7} {'v/day':>7} {'min':>5}  channel / title")
    for i, r in enumerate(rows[:top], 1):
        score = r[sort_key]
        print(f"{i:>3} {short(score) if score >= 1000 else score:>8} {short(r['views']):>7} {short(r.get('subs')):>7} "
              f"{short(r['views_per_day']):>7} {r['duration_min']:>5}  {r['channel'][:22]} | {r['title'][:60]}")


def main():
    for stream in (sys.stdout, sys.stderr):  # Windows consoles choke on emoji in titles
        try:
            stream.reconfigure(errors="replace")
        except Exception:
            pass
    ap = argparse.ArgumentParser(description="Rank recent YouTube videos by how much they out-perform their channel.")
    ap.add_argument("--key", default=os.environ.get("YT_API_KEY"), help="API key (default: env YT_API_KEY)")
    ap.add_argument("--queries", help="comma-separated search terms, or a .txt file with one per line")
    ap.add_argument("--days", type=int, default=10, help="only videos published in the last N days (default 10)")
    ap.add_argument("--pages", type=int, default=2, help="search pages of 50 per query (default 2 = up to 100)")
    ap.add_argument("--duration", default="long", choices=["any", "short", "medium", "long"],
                    help="short <4 min, medium 4-20 min, long >20 min (default long)")
    ap.add_argument("--region", default="US")
    ap.add_argument("--lang", default="en")
    ap.add_argument("--min-views", type=int, default=5000, help="ignore videos below N views (filters tiny-channel noise, default 5000)")
    ap.add_argument("--max-subs", type=int, default=0, help="keep only channels with at most N subscribers (0 = no limit)")
    ap.add_argument("--median", action="store_true", help="also compute views / channel median of last 10 uploads (costs more units)")
    ap.add_argument("--sort", default="views_per_sub", choices=["views_per_sub", "views_per_day", "x_median", "views"])
    ap.add_argument("--top", type=int, default=30)
    ap.add_argument("--out", default="scan_results.csv")
    ap.add_argument("--save-json", help="also save the raw rows as JSON (re-rank later with --from-json)")
    ap.add_argument("--from-json", help="skip the API and rank rows from a JSON file")
    a = ap.parse_args()

    t0 = time.time()
    if a.from_json:
        with open(a.from_json, encoding="utf-8") as f:
            rows = json.load(f)
    else:
        if not a.key:
            sys.exit("No API key. Set YT_API_KEY or pass --key. (Google Cloud console > APIs & Services > Credentials)")
        if a.queries and os.path.isfile(a.queries):
            with open(a.queries, encoding="utf-8") as f:
                queries = [l.strip() for l in f if l.strip()]
        else:
            queries = [q.strip() for q in (a.queries or ",".join(DEFAULT_QUERIES)).split(",") if q.strip()]
        if len(queries) * a.pages > 100:
            sys.exit("That is more than 100 search calls, the default daily search quota. Use fewer queries or --pages.")
        print(f"Scanning {len(queries)} queries, last {a.days} days, duration={a.duration} ...", file=sys.stderr)
        ids = search_ids(a.key, queries, a.days, a.pages, a.duration, a.region, a.lang)
        videos = fetch_videos(a.key, ids)
        channels = fetch_channels(a.key, list({v["channel_id"] for v in videos.values()}))
        medians = channel_medians(a.key, channels) if a.median else {}
        rows = []
        for v in videos.values():
            c = channels.get(v["channel_id"], {})
            v["subs"] = c.get("subs")
            v["channel_videos"] = c.get("channel_videos")
            v["channel_median"] = medians.get(v["channel_id"])
            rows.append(v)
        if a.save_json:
            with open(a.save_json, "w", encoding="utf-8") as f:
                json.dump(rows, f, ensure_ascii=False, indent=1)

    rows = [r for r in rows if r.get("views", 0) >= a.min_views]
    if a.max_subs:
        rows = [r for r in rows if r.get("subs") is not None and r["subs"] <= a.max_subs]
    ranked = rank(rows, a.sort)
    print_table(ranked, a.top, a.sort)

    cols = ["video_id", "title", "channel", "subs", "channel_videos", "published", "age_days", "duration_min",
            "views", "likes", "comments", "views_per_day", "views_per_sub", "channel_median", "x_median", "url"]
    with open(a.out, "w", newline="", encoding="utf-8-sig") as f:
        w = csv.DictWriter(f, fieldnames=cols, extrasaction="ignore")
        w.writeheader()
        w.writerows(ranked)
    print(f"\nSaved {len(ranked)} rows to {a.out}  |  {time.time() - t0:.0f}s  |  "
          f"quota used: {USED['search']} search calls + {USED['units']} units", file=sys.stderr)


if __name__ == "__main__":
    main()
views/sub
צפיות חלקי מנויים. סרטון ב-50× אומר שהאלגוריתם הפיץ אותו הרבה מעבר לקהל של הערוץ. זה האות הכי חזק.
views/day
צפיות חלקי ימים מאז ההעלאה. מנטרל את היתרון של סרטונים ותיקים.
x_median (עם --median)
צפיות חלקי החציון של 10 ההעלאות האחרונות בערוץ. זה המדד שהפוסט מציג: "כמה הסרטון ניצח את הערוץ שלו".
חשבון quota: ברירת המחדל (8 נושאים × 2 עמודים) = 16 קריאות חיפוש מתוך 100 ביום, ועוד כמה עשרות יחידות מתוך 10,000. --median מוסיף קריאה לכל ערוץ, עדיין הרחק מתחת למכסה. המכסה מתאפסת בחצות שעון פסיפיק (בערך 10:00 בבוקר בישראל). הסקריפט מדפיס בסוף כמה השתמש.
רוצים ש-Claude Code יריץ ויסביר? פרומפט
Run `python yt_scanner.py --days 10 --duration long --median --save-json scan.json`.
Then read scan_results.csv and give me:
1. The 15 videos with the highest views_per_sub, grouped by channel.
2. For each channel: subscribers, upload frequency in the data, average length.
3. Which of these channels have no person on camera (judge from titles + channel names, mark "unsure" if you can't tell).
מה הפרומפט עושה: נותן ל-Claude Code להריץ את הסורק בתיקייה שלכם, לקרוא את ה-CSV ולסכם אותו. בלי Claude Code? פותחים את הקובץ בגוגל שיטס ומעלים אותו ל-claude.ai עם אותה בקשה.
מה יוצא מהשלב?טבלה מדורגת בטרמינל + קובץ scan_results.csv עם כל הסרטונים והקישורים.
▶
LIVE DEMO
הסריקה שלנו, 16.11.2026: נתונים אמיתיים
הרצנו את פונקציית הדירוג של הסורק על נתונים ציבוריים אמיתיים: 6 חיפושים, סרטונים מהשבוע האחרון שאורכם מעל 20 דקות, 69 סרטונים. מכיוון שלא יצרנו מפתח API בשביל המדריך, את הנתונים הגולמיים אספנו מעמודים ציבוריים, והזנו לסורק עם --from-json. בחרו מדד, מיינו את הטבלה, ולחצו על כותרת כדי לפתוח את הסרטון.
yt_scanner.py --from-json
#
video · channel
subs
views
v/day
v/sub
min
מה רואים כבר בסריקה קטנה: 6 מתוך 10 המובילים הם ערוצים מתחת ל-10,000 מנויים, החציון של אורך הסרטון אצלם 32 דקות, ו-4 מתוך 10 הגיעו מהחיפוש "survival story documentary". זה בדיוק סוג התובנה שהפוסט מדבר עליו. שימו לב: זו דגימה של יום אחד, לא מחקר.
03
STEP 03 / 10
מוצאים את הדפוס המשותף
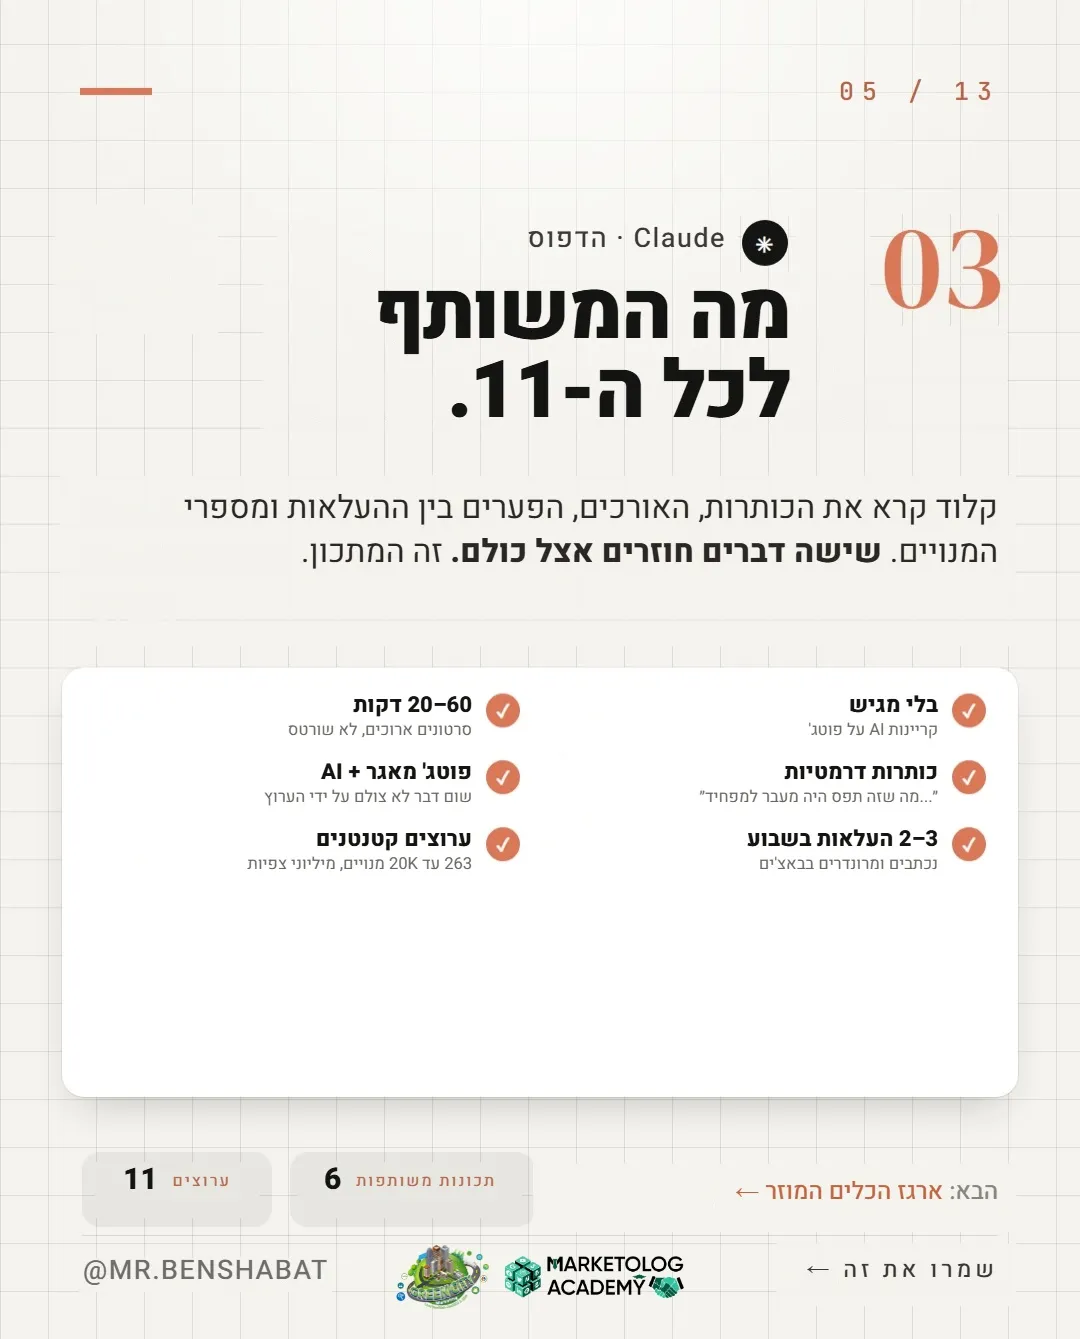
נותנים ל-Claude את ה-CSV ומבקשים ממנו לחשוב כמו אנליסט. לפי הפוסט, אצל 11 הערוצים שנמצאו חזרו שישה דברים:
פרומפט: חילוץ הדפוס
Attached: scan_results.csv from my YouTube scanner (videos from the last 10 days,
ranked by views per subscriber).

Act as a YouTube data analyst. Using ONLY the data in the file:
1. List the shared traits of the top 20 videos: title structure, length,
   topic, channel size, upload gaps (from the dates), face on camera or not (guess from titles, mark unsure).
2. Write 10 title templates that copy the STRUCTURE, never the exact titles.
3. Tell me which traits might be noise because the sample is small.
מה הפרומפט עושה: מבקש תבניות של כותרות, לא העתקה, ומזהיר מראש מרעש סטטיסטי.
מה יוצא מהשלב?"מתכון" כתוב: נושא, אורך, סגנון כותרת וקצב העלאה, שמבוסס על נתונים ולא על תחושה.
01בלי מגישקריינות AI על פוטג'
02כותרות דרמטיות"מה שזה תפס היה מעבר למפחיד…"
032–3 העלאות בשבוענכתבים ומרונדרים בבאץ'
0420–60 דקותסרטונים ארוכים, לא שורטס
05פוטג' מאגר + AIשום דבר לא צולם על ידי הערוץ
06ערוצים קטנטנים263 עד 20K מנויים, מיליוני צפיות
ששת המאפיינים כפי שהפוסט מציג אותם. הסריקה שלנו הראתה אותו כיוון (ערוצים קטנים, 20+ דקות).
04
STEP 04 / 10
ארגז הכלים: שבעה מתוך שמונה חינמיים
אלה שמונת הכלים מהפוסט. בדקנו כל אחד:
yt-dlp: כלי שורת פקודה בקוד פתוח שמושך מטא-דאטה וכתוביות של סרטונים.
Whisper large-v3 (OpenAI, קוד פתוח): תמלול עם חותמות זמן.
Kokoro-82M: קריינות באנגלית על הלפטופ, Apache-2.0.
Dia-1.6B (Nari Labs): דיאלוג בשני קולות ([S1]/[S2]), אנגלית בלבד, כ-4.4GB VRAM.
ClearerVoice-Studio: ניקוי רעשים ושיפור איכות דיבור (pip install clearvoice).
Wan2GP: וידאו AI על המחשב שלכם.
ElevenLabs v3: קריינות דוקומנטרית. תוכנית חינמית של 10,000 קרדיטים (כ-10 דקות) בחודש; רישיון מסחרי מתחיל ב-Starter, $6 לחודש.
Nano Banana (מודל התמונות של Gemini): תמונות ממוזערות. יש מכסה חינמית יומית שמשתנה מדי פעם.
yt-dlp ו-Whisper משמשים למחקר: להבין מבנה של סרטון מצליח. העלאה של תוכן של אחרים, גם בשינויים קטנים, נופלת תחת מדיניות ה-"reused content" של יוטיוב ולא תקבל מונטיזציה. בנוסף, תנאי השימוש של יוטיוב מגבילים הורדה של תוכן בלי רשות.
מה יוצא מהשלב?רשימת כלים מותקנים לפי מה שאתם באמת צריכים. לא חייבים את כל השמונה.
תוך כדי: טבלת ה-quota הרשמית. search.list ו-videos.insert בבאקט של 100 קריאות ביום כל אחד, ו-10,000 יחידות לשאר (צילום אמיתי).
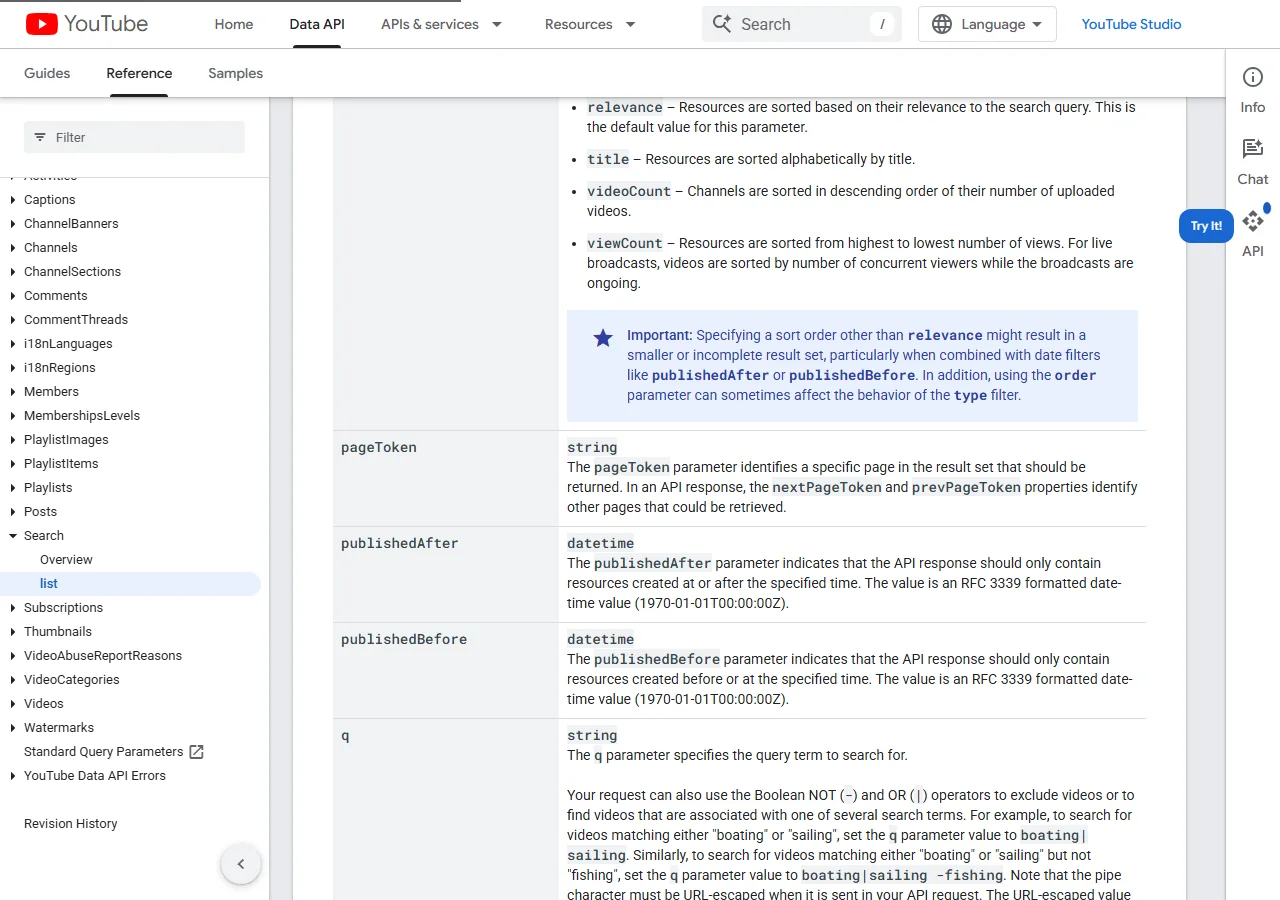
developers.google.com/youtube/v3/docs/search/list
הפרמטרים שהסורק משתמש בהם: order=viewCount ו-publishedAfter (צילום אמיתי).
05
STEP 05 / 10
Claude כותב את התסריט
בפוסט זה נעשה בשורה אחת ב-Claude Code, במצב לא אינטראקטיבי (-p). התקנת Claude Code ב-Windows (PowerShell), לפי התיעוד הרשמי:
התקנה
irm https://claude.ai/install.ps1 | iex
ב-Mac/Linux: curl -fsSL https://claude.ai/install.sh | bash. אחר כך:
תסריט בשורה אחת
claude --model opus -p "Write a 60-second YouTube documentary narration in the style of a faceless wildlife channel, about [your topic]. First line must be a hook. Short sentences. About 140 words." > narration.txt
לסרטון ארוך (20+ דקות, כמו בערוצים שמצאנו), עדיף לבקש קודם מבנה:
פרומפט: מבנה לסרטון של 25 דקות
Plan a 25-minute faceless documentary for YouTube about [topic].
Audience: US, adults. Tone: calm, cinematic, suspenseful.
1. 3 title options in the style of the title templates I give you: [paste 3 templates].
2. Cold open (first 30 seconds) written out in full: it must promise a payoff.
3. 8 chapters with: chapter title, key facts to cover (flag anything that needs fact-checking), and a cliffhanger line into the next chapter.
4. For each chapter, 5 B-roll ideas I could find as free stock footage or generate.
Only use facts you are confident about. Mark uncertain facts with [CHECK].
ב--p Claude Code מדפיס את התשובה ויוצא, כך שאפשר לשרשר אותו לסקריפטים. מודל opus הוא החזק ביותר; sonnet מהיר וזול יותר במגבלות השימוש.
מה יוצא מהשלב?narration.txt לסרטון, עם עובדות מסומנות לבדיקה.
מתוך הפוסט: הפקודה claude --model opus -p בטרמינל.
06
STEP 06 / 10
המודלים שמאחורי הפוטג'
הפוסט מציין ארבעה מקורות. הנה מה שכל אחד עושה ובכמה (מחירים משתנים, בדקו לפני):
Veo 3 (Google): קליפים קולנועיים קצרים עם סאונד. בתשלום דרך מנויי Gemini או ה-API; לפי השוואות צד שלישי, בערך $0.05–$0.40 לשנייה לפי הדרגה.
Seedance (ByteDance): חיות ותנועה. זמין דרך פלטפורמות כמו Dreamina, עם קרדיטים חינמיים מוגבלים בחלקן.
Wan 2.2: חינם, רץ על המחשב שלכם דרך Wan2GP. איטי יותר, אבל בלי עלות לקליפ.
Nano Banana: לתמונות ולתמונה הממוזערת.
לפי הפוסט העלות היא מאפס ועד כמה עשרות סנטים לקליפ (בערך עד $0.40). ובסרטון של 25 דקות לא חייבים AI בכל שוט: ארכיונים ציבוריים מספקים פוטג' אמיתי. בדמו של הפוסט השתמשו בפוטג' של Ifremer (רישיון CC BY 4.0, מחייב קרדיט) ו-NOAA.
פוטג' AI שנראה מציאותי (למשל "צילומים מתחת למים של הטיטאניק") מחייב לסמן AI use: Yes בטופס ההעלאה של יוטיוב, תחת Attributes. ובכל קובץ ארכיון: בדקו את שורת הרישיון ותנו קרדיט בתיאור.
מה יוצא מהשלב?תיקיית B-roll לכל פרק: חלק מארכיונים חופשיים, חלק מיוצר.
מתוך הפוסט: 20 שניות מהסרטון שנבנה בשיטה. תסריט של Claude, פוטג' חינמי ממעמקי הים, כתוביות וחיתוך.
07
STEP 07 / 10
הקול
שתי אפשרויות, כמו בפוסט:
ElevenLabs v3: Text to Speech, בוחרים קול מקטגוריית Narration, מדביקים את narration.txt. החינמי מספיק בערך לסרטון אחד בשבוע; לערוץ עם מונטיזציה צריך רישיון מסחרי (Starter ומעלה). v3 תומך גם בעברית.
Kokoro-82M: חינם על הלפטופ, באנגלית. קוד מלא נמצא במדריך השורטס שלנו; ההתקנה: pip install "kokoro>=0.9.4" soundfile.
ניקוי רעשים (אם הקלטתם או ערבבתם מקורות) עם ClearerVoice:
מה יוצא מהשלב?קובץ קריינות נקי, באורך של הסרטון כולו.
מתוך הפוסט: ששת הדברים שחוזרים אצל כל 11 הערוצים.
08
STEP 08 / 10
בונים את הסרטון
כתוביות: Whisper יוצר קובץ SRT מהקריינות: whisper narration_clean.wav --model large-v3 --output_format srt.
עריכה: מניחים את הקריינות על ציר הזמן ב-DaVinci Resolve או CapCut, ומכסים כל משפט ב-B-roll מתאים. כל 4–8 שניות חיתוך.
תמונה ממוזערת: ב-Gemini (Nano Banana) מבקשים תמונה דרמטית אחת עם נושא ברור, ומוסיפים 2–4 מילים גדולות.
העלאה: ב-YouTube Studio: כותרת לפי תבנית מהשלב השלישי, תיאור עם קרדיטים לפוטג', AI use לפי הצורך, ותזמון.
ערוצים דוקומנטריים בלי פנים הם בדיוק מה שמדיניות ה-"inauthentic content" של יוטיוב בודקת: תוכן מתבנית, חוזר או מיוצר בהמוניות. מה שמגן עליכם: מחקר אמיתי, עובדות מדויקות, מבנה ייחודי, וקצב סביר (2–3 בשבוע, כמו הערוצים שנמצאו).
מה יוצא מהשלב?סרטון של 20+ דקות עם קריינות, B-roll, כתוביות ותמונה ממוזערת, מתוזמן לפרסום.
מתוך הפוסט: הסריקה בטרמינל, 1,283 מועמדים מדורגים לפי צפיות ÷ חציון הערוץ.
09
STEP 09 / 10
הסטאק המלא, מחשב נייד אחד
הפוסט אומר "אפס בחודש". בפועל: כמעט אפס. הסריקה, הקול (Kokoro), הווידאו המקומי (Wan 2.2) והעריכה חינמיים. מה שעולה כסף, אם בוחרים בו: Claude Code (Pro, $17–$20 לחודש), ElevenLabs מסחרי ($6 ומעלה), וקליפים מ-Veo או Seedance.
מה יוצא מהשלב?תמונה ברורה של העלות החודשית שלכם, לפני שמתחייבים.
yt_scanner.py מוצא מה שכבר עובד$0
Claude ניתוח, כותרות, תסריט$0 / Pro
ElevenLabs / Kokoro קריין$0–$6
Veo / Seedance / Wan 2.2 פוטג'$0–$0.40 לקליפ
Whisper + עורך כתוביות, עריכה, גרפיקה$0
YouTube משלם, אחרי YPP$$
10
STEP 10 / 10
כמה זה משלם
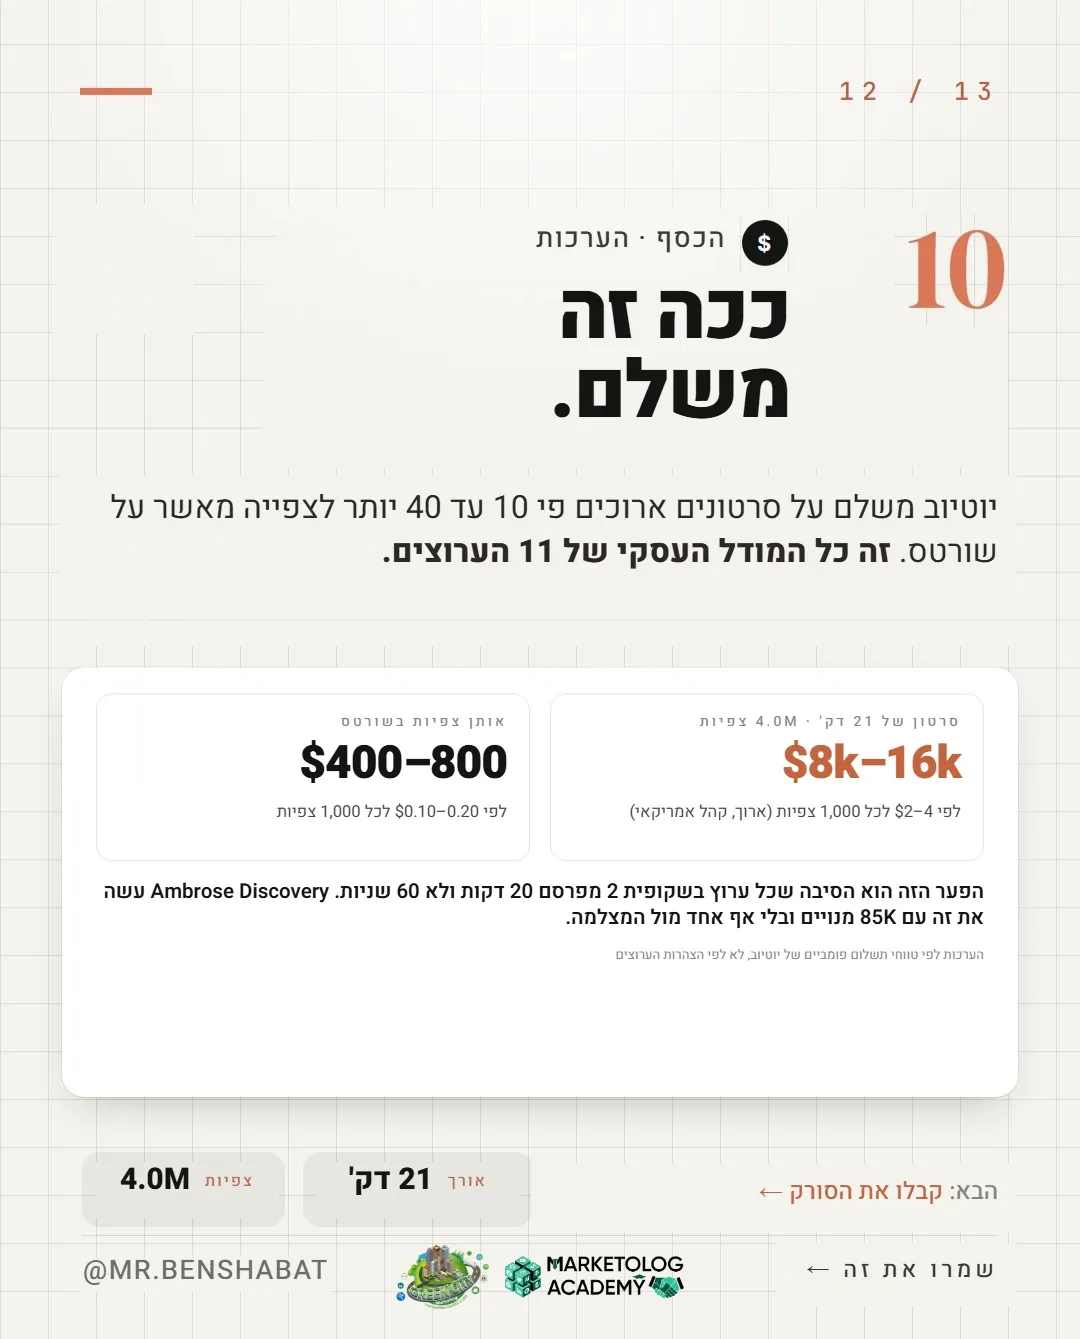
הפוסט מעריך שסרטון של 21 דקות עם 4 מיליון צפיות שווה $8K–$16K (לפי $2–$4 ל-1,000 צפיות), ושאותן צפיות בשורטס שוות $400–$800. אלה הערכות של הפוסט, לא נתונים של הערוץ. הכיוון נכון: יוטיוב משלמת על צפייה בסרטון ארוך פי עשרות יותר מאשר בשורט. הערכות צד שלישי ל-2026 נותנות לשורטס בערך $0.03–$0.10 ל-1,000 צפיות. שחקו עם המספרים:
כדי לקבל בכלל כסף: תוכנית השותפים דורשת היום 1,000 מנויים ו-4,000 שעות צפייה ב-12 חודשים (או 10M צפיות שורטס ב-90 יום). מ-1 בפברואר 2027, מצטרפים חדשים יצטרכו 8,000 שעות צפייה ב-365 יום (או 20M צפיות שורטס ב-90 יום). זה מקור: עמוד העזרה ובלוג יוטיוב הרשמיים, 10.8.2026.
מה יוצא מהשלב?יעד ריאלי: כמה סרטונים ארוכים, באיזה קצב, עד 8,000 שעות צפייה.
ה-API לא הופעל בפרויקט, או שהמפתח מוגבל ל-API אחר. חזרו ל-API Library ובדקו ש-YouTube Data API v3 במצב Enabled, ושהמפתח מוגבל אליו.
Quota exhausted
עברתם 100 קריאות חיפוש ביום. הורידו --pages או מספר נושאים, או חכו לאיפוס בחצות שעון פסיפיק.
subs ריק בטבלה
ערוצים שהסתירו את מספר המנויים. הסורק מדלג עליהם בדירוג views/sub. אפשר למיין לפי --sort views_per_day.
תוצאות "מוזרות" בראש
ערוץ עם 4 מנויים ו-200 צפיות נותן יחס גבוה ולא אומר כלום. לכן יש --min-views (ברירת מחדל 5,000). העלו ל-50,000 לסינון חזק.
להעתיק ערוץ שמצאתם
מעתיקים מבנה ונושא, לא כותרות, תמונות או טקסט. "Reused content" לא מקבל מונטיזציה, גם עם שינויים קטנים.
המפתח בתוך הקוד
קוד שעולה ל-GitHub עם מפתח בפנים = מפתח שנגנב. תמיד משתנה סביבה YT_API_KEY.
מהפוסט
השקופיות המקוריות
מבחר מהקרוסלה. חלק מהשקופיות הן סרטונים.
שאלות נפוצות
שאלות ותשובות
האם באמת "Claude סרק"? או הסקריפט?
הסקריפט עושה את הסריקה, Claude עושה את החשיבה. ב-Claude Code אפשר לבקש ממנו לכתוב את הסקריפט, להריץ אותו ולסכם את התוצאות, אבל הנתונים מגיעים מה-API של יוטיוב. הסקריפט במדריך עובד גם בלי Claude בכלל.
כמה זמן לוקחת סריקה?
תלוי בכמות. 16 חיפושים של 100 תוצאות ועוד שליפת נתונים לוקחים בדרך כלל דקות בודדות. הפוסט מדבר על 3–4 דקות ל-1,283 סרטונים, וזה סביר.
זה עולה כסף ב-Google Cloud?
לא, אם נשארים במכסה היומית החינמית. יוטיוב לא גובה על ה-quota; אם צריך יותר, מגישים בקשה להגדלה.
אפשר לסרוק נישות בעברית?
כן. משנים --region IL --lang he ומחפשים בעברית. רק זכרו שהשוק קטן בהרבה, וההכנסה לצפייה בדרך כלל נמוכה יותר מהשוק האמריקאי.
איפה רשימת 11 הערוצים מהפוסט?
הפוסט מציג אותה בשקופית השנייה, אבל לא יכולנו לאמת את המספרים. חשוב מזה: רשימה כזו מתיישנת תוך שבועות. הסורק נותן לכם רשימה עדכנית בכל יום שתריצו אותו.
יוטיוב לא תסגור ערוץ AI?
שימוש ב-AI מותר. מה שלא מקבל מונטיזציה הוא תוכן המוני, חוזר או מועתק, ופרסונות AI שנותנות עצות רפואיות, משפטיות או פיננסיות. ערוץ עם מחקר אמיתי וקצב סביר נמצא בצד הנכון.
צ'קליסט הסורק
רוצים עוד מערכות כאלה?
עקבו אחרי @mr.benshabat
כל שבוע: מערכות AI, אוטומציות ושיווק דיגיטלי, מוסברים צעד אחר צעד.