Green City Marketing Marketolog Academy לשידור ←
BREAKING

מדריך מעשי · ערוץ עם מגיש וירטואלי

המגיש לא קיים. האחריות כן.

תמונה אחת וקובץ אודיו אחד נכנסים, ויוצא מגיש שמדבר. HunyuanVideo-Avatar מייצר את המגיש, קלוד כותב את התסריט ו-ElevenLabs (או Kokoro בחינם) נותן לו קול. המדריך הזה מלמד את כל הצנרת, ובודק בכנות מה יוטיוב מרשה, מה הוא מממן, ומה צריך כדי להשתמש בפנים ובקול של מישהו.

⏱ התקנה: ערב🎙 סרטון: 2-3 שעות בהתחלה💸 כלים: $0-$6 לחודש🖥 צריך: GPU של 10GB+
PREVIEW · HTML MOCK · המחשהphoto + audio → presenter

Fact check

בדיקת עובדות לפוסט

הפוסט מבטיח אפליקציה חינמית, מגיש שלא קיים ו-$140K ב-90 יום. בדקנו כל טענה מול המקור הרשמי (נכון ל-16.11.2026).

2.2Kכוכבים ל-HunyuanVideo-Avatar ב-GitHub
10GBVRAM במצב החסכוני (דרך Wan2GP)
24GBמינימום רשמי בהרצה המקורית, "very slow"
10Kקרדיטים בחודש ב-ElevenLabs Free (כ-10 דקות)
TRUE*"אפליקציה חינמית בקוד פתוח, מבית Tencent"

לפי הפוסט: HunyuanVideo-Avatar, חינם לתמיד.

נכון, עם כוכבית: הרישיון הוא Tencent Hunyuan Community License ולא רישיון קוד פתוח רגיל. הוא לא חל באיחוד האירופי, בבריטניה ובדרום קוריאה, ואסור להשתמש בו או בתוצרים שלו מחוץ לטריטוריה. ישראל בפנים. Tencent לא תובעת זכויות על התוצרים שלכם.

PARTLY"רצה על כרטיס מסך של 10GB, או בהתקנה בקליק דרך Pinokio"

לפי הפוסט: GPU אחד של 10GB או שרת שכור.

ה-README הרשמי: מינימום 24GB, מומלץ 96GB, נבדק רק על Linux. מצב ה-10GB קיים בזכות Wan2GP/WanGP, והוא הדרך המעשית במחשב ביתי. ב-Pinokio יש סקריפט ל-WanGP. לא מצאנו התקנה רשמית ב-Pinokio ל-HunyuanVideo-Avatar עצמו.

POLICY RISK"ערוץ פיננסים בלי פנים עם מגיש AI"

לפי הפוסט (שקופית 5): תסריט על "3 הרגלים לבניית עושר".

במדיניות המונטיזציה של יוטיוב כתוב במפורש: ערוצים עם פרסונות AI שמוצגות כמומחים אנושיים בנושאי בריאות, משפט, כספים או פוליטיקה לא זכאים למונטיזציה. הדוגמה שם היא ממש "AI podcast hosts giving financial advice". בחרו נישה אחרת, או הציגו את המגיש בגלוי כ-AI ולא כמומחה.

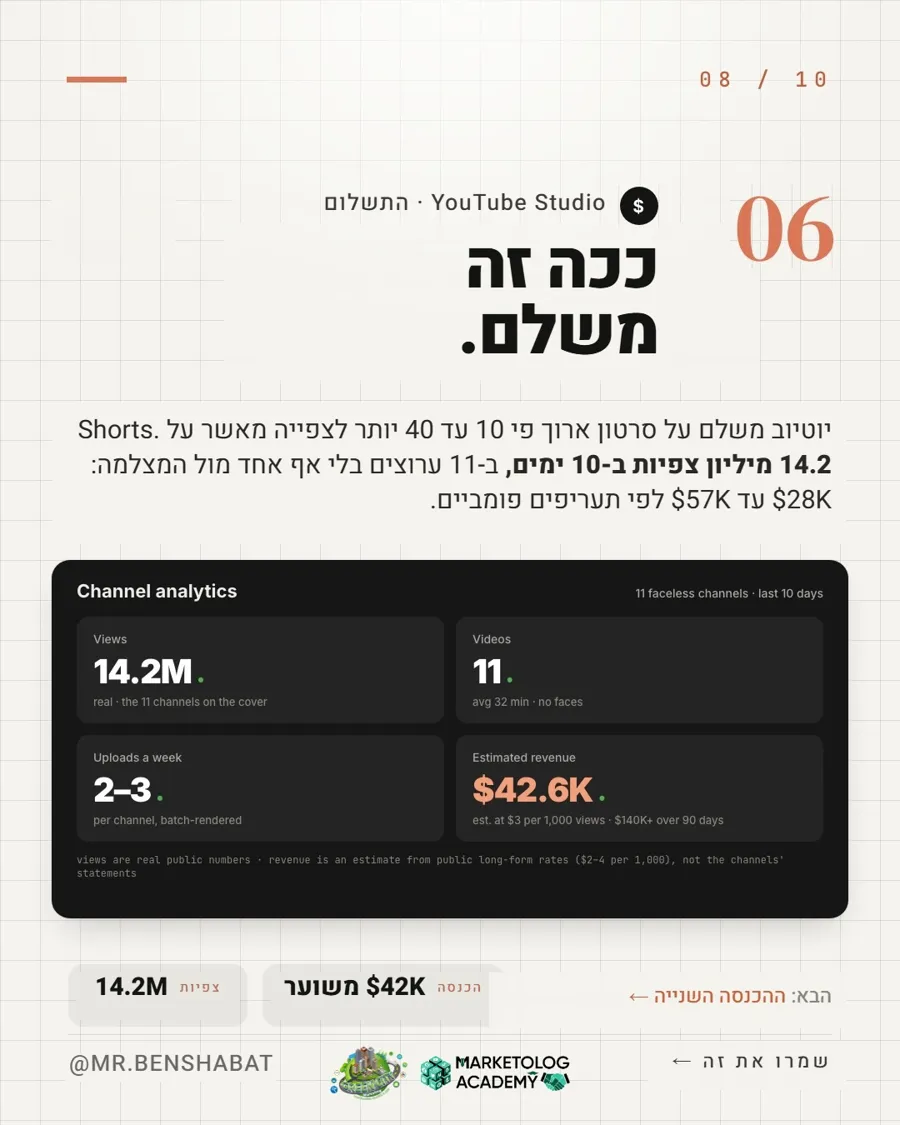
UNVERIFIED"$140K ב-90 יום, 14.2M צפיות ב-10 ימים, 11 ערוצים"

לפי הפוסט (שקופית 8): ההכנסה "מוערכת לפי תעריפים פומביים".

השקופית עצמה מודה שזה אומדן ולא דוח הכנסות, ואין שמות ערוצים לבדוק. לא נציג את זה כעובדה. מה שמאומת: אין הכנסה מפרסומות לפני קבלה ל-YPP.

Pre-production

מה צריך באולפן

🖥 GPU

חובה

NVIDIA עם 10GB+ VRAM ל-WanGP במצב חסכוני, או שרת GPU שכור לפי שעה. ההרצה הרשמית: Linux ו-24GB לפחות.

✳ Claude

יש חינמי

Free מספיק לתסריטים. Pro ‏($17 בתשלום שנתי / $20 חודשי) אם רוצים Claude Code לאוטומציה.

מחירים ↗

🎙 קול

יש חינמי

ElevenLabs Free לניסיון (לא מסחרי). לערוץ שמרוויח: Starter (‏$6 לחודש במחירון, כולל רישיון מסחרי). או Kokoro-82M המקומי, חינם וברישיון Apache 2.0.

📸 תמונה עם זכויות

חובה

פנים שנוצרו ב-AI ולא דומות לאדם אמיתי, או הפנים שלכם, או אדם שחתם על הסכמה. לא תמונה מגוגל.

Rundown

סדר השידור

שבעה סגמנטים, מהתקנה ועד סרטון באוויר. 1-2 עושים פעם אחת, ו-3-7 חוזרים בכל סרטון.

01
SEGMENT 1/7 · פעם אחת

מריצים את HunyuanVideo-Avatar (שלוש דרכים)

HunyuanVideo-Avatar של Tencent Hunyuan (פורסם ב-28.5.2025) מקבל תמונת דמות + אודיו ומייצר וידאו של הדמות מדברת או שרה, עם תנועה ורגש. לפי ה-README הוא תומך בדמויות פוטוריאליסטיות, מצוירות, תלת-ממדיות ואנתרופומורפיות, בפורטרט, בחצי גוף ובגוף מלא.

  1. במחשב Windows (מומלץ): דרך WanGP. שם רצה הגרסה החסכונית של 10GB. מתקינים לפי ה-README של WanGP (WanGP Manager, Pinokio עם סקריפט wan2gp, או ידני) ובוחרים במודלים את Hunyuan Video Avatar. לפי התיעוד, באותה משפחה זמינים גם InfiniteTalk ו-LongCat Avatar 1.5, שגם הם עוקבים אחרי אודיו של דיבור.
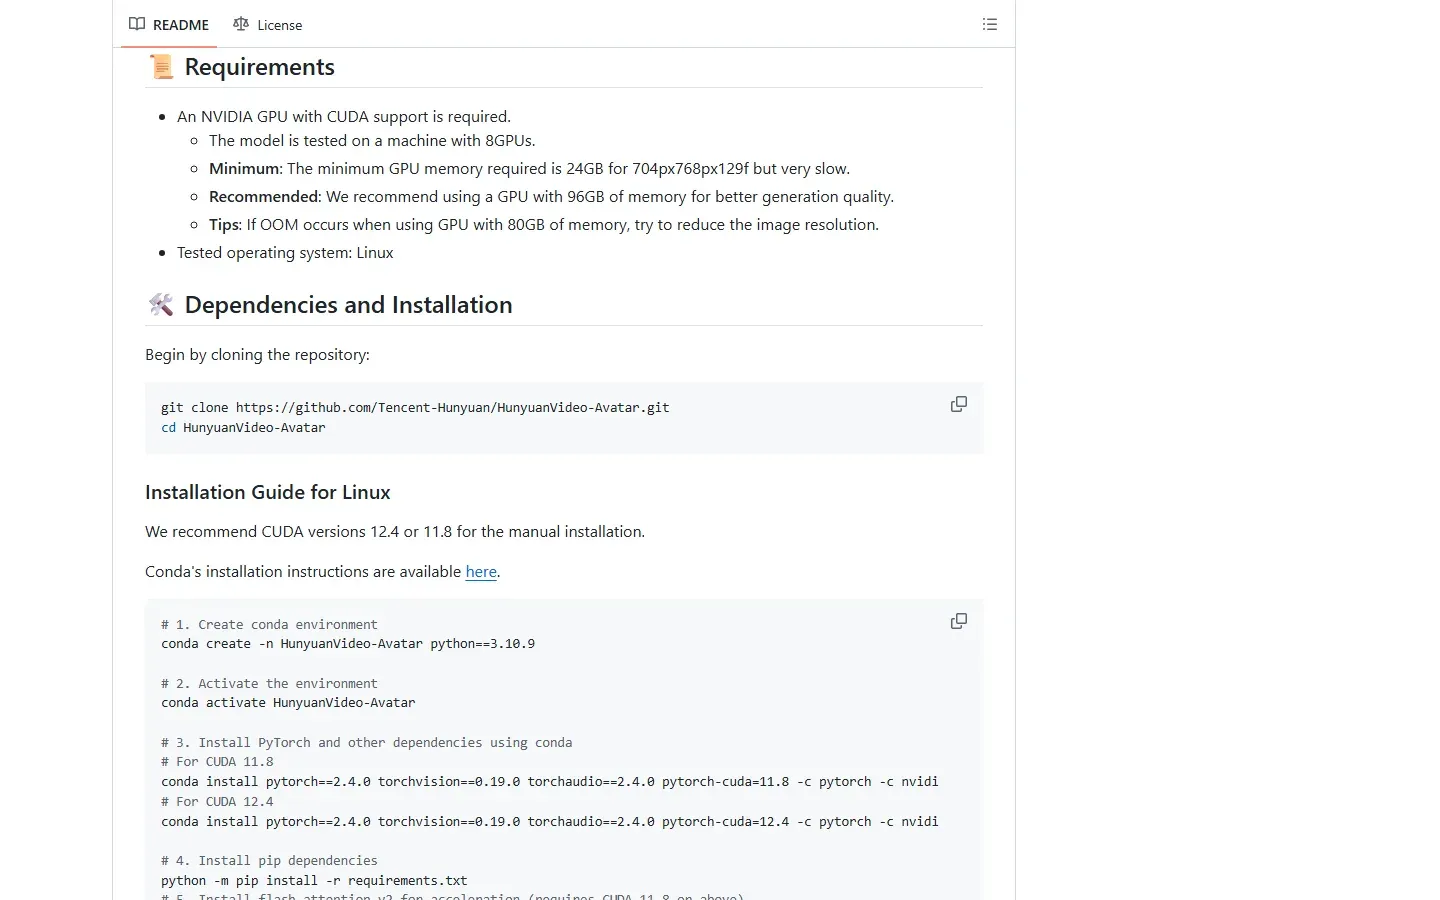
  2. על Linux עם GPU חזק: ההתקנה הרשמית (conda + PyTorch + flash-attention), ואז ממשק Gradio עם bash ./scripts/run_gradio.sh.
  3. בלי GPU: שרת שכור לפי שעה. זה כבר לא $0, אבל משלמים רק על שעות רינדור.
Linux · התקנה רשמית (מתוך ה-README)
git clone https://github.com/Tencent-Hunyuan/HunyuanVideo-Avatar.git
cd HunyuanVideo-Avatar
conda create -n HunyuanVideo-Avatar python==3.10.9
conda activate HunyuanVideo-Avatar
conda install pytorch==2.4.0 torchvision==0.19.0 torchaudio==2.4.0 pytorch-cuda=12.4 -c pytorch -c nvidia
python -m pip install -r requirements.txt
# then: flash-attention v2.6.3 + model weights, as described in the README
bash ./scripts/run_gradio.sh
לפני הורדה: הרישיון של Tencent לא חל באיחוד האירופי, בבריטניה ובדרום קוריאה. אם הלקוח או הערוץ שלכם שם, אל תשתמשו במודל הזה.
מה יוצא מהשלב?ממשק בדפדפן (WanGP או Gradio) שבו מעלים תמונה ואודיו ולוחצים על יצירה.
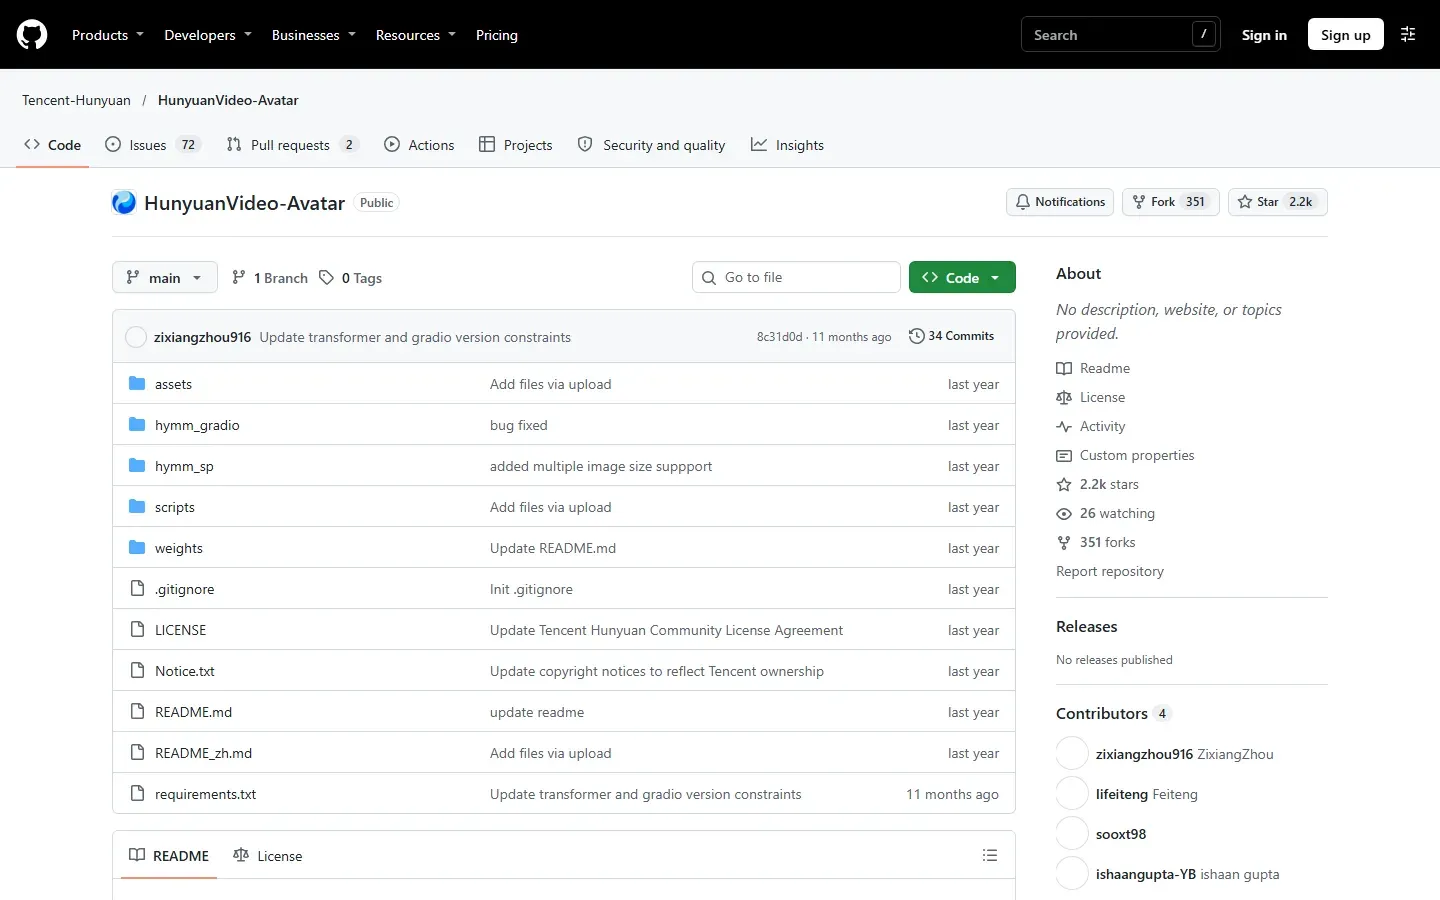
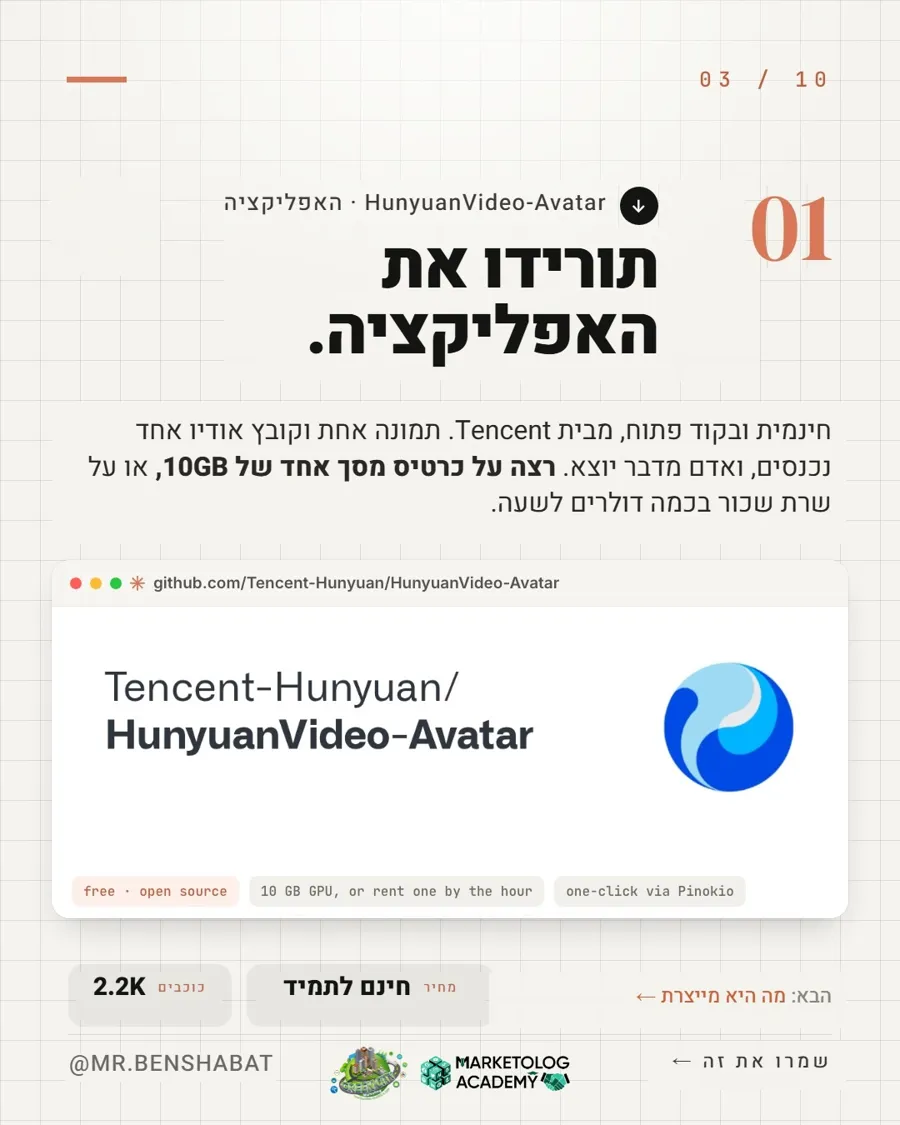
github.com/Tencent-Hunyuan/HunyuanVideo-Avatar
מאגר HunyuanVideo-Avatar ב-GitHub, 2.2K כוכבים
המאגר הרשמי: 2.2K כוכבים, קובץ LICENSE של Tencent Hunyuan Community License.
HunyuanVideo-Avatar · README · Requirements
דרישות החומרה ב-README של HunyuanVideo-Avatar
דרישות החומרה הרשמיות. מצב ה-10GB מגיע דרך Wan2GP.
02
SEGMENT 2/7 · פעם אחת לערוץ

הפנים של הערוץ: תמונה אחת, נקייה, עם זכויות

שלוש אפשרויות, לפי סדר הבטיחות:

  1. מגיש/ה שנוצר ב-AI ולא דומה לאף אדם אמיתי. ב-WanGP: לשונית Text to Image עם מודל תמונה (Qwen Image, Flux ודומיהם).
  2. אתם: תמונה שלכם. אתם הבעלים של הפנים.
  3. אדם אחר רק עם הסכמה כתובה ומפורשת (תבנית בסעיף מדיניות והסכמה).
פרומפט · מגיש/ה בדיוי/ה
Photorealistic studio portrait of a fictional news presenter in her early 30s, not resembling any real person or celebrity, shoulders-up, facing the camera, mouth gently closed, neutral friendly expression, soft key light, plain dark-blue studio background, sharp focus on the face, no text, no logos, no jewelry covering the mouth.

בעברית: מגישה בדיונית, פנים ישר למצלמה, פה סגור, תאורה רכה ורקע נקי. ככה המודל מסנכרן שפתיים הכי טוב.

טיפים לתמונה: פנים במרכז ובגודל טוב, בלי ידיים או מיקרופון מול הפה, תאורה אחידה. רוצים שהמגיש ייראה כמו דמות מצוירת? המודל תומך גם בזה, וזה גם פותר חלק מסוגיות הגילוי.
מה יוצא מהשלב?presenter.png, אותה תמונה לכל הסרטונים, כדי שהמגיש יהיה מזוהה.
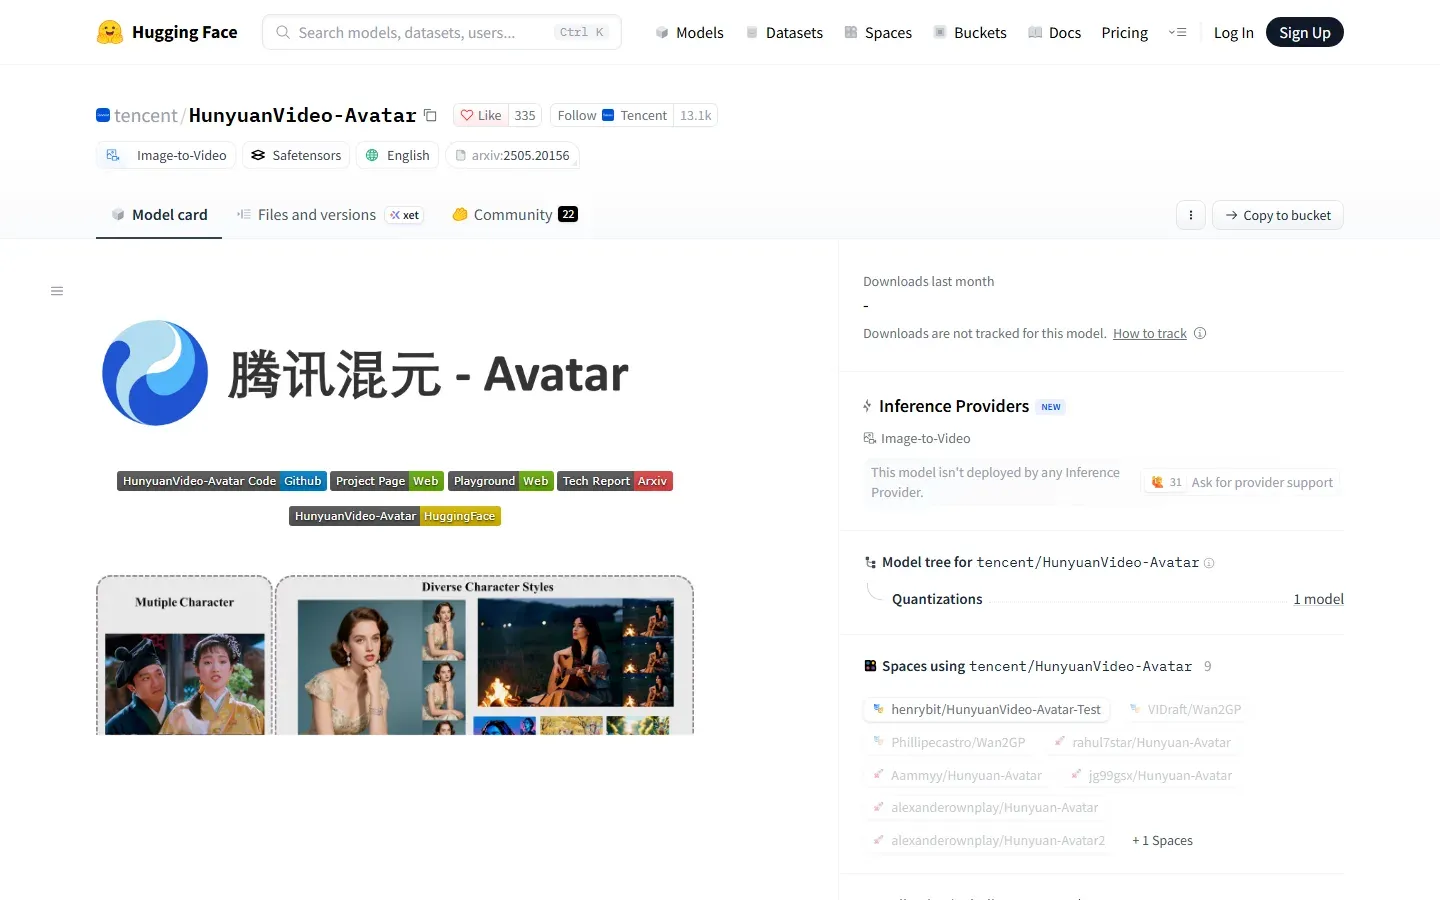
huggingface.co/tencent/HunyuanVideo-Avatar
דף המודל HunyuanVideo-Avatar ב-Hugging Face עם דוגמאות לסגנונות דמות
דף המודל ב-Hugging Face: דוגמאות למספר דמויות ולסגנונות שונים.
03
SEGMENT 3/7 · כל סרטון

קלוד כותב את התסריט, מחולק לסגמנטים

שני שינויים לעומת הפרומפט בפוסט: (1) נישה בטוחה (היסטוריה, מדע, טכנולוגיה, טיולים, ולא "ייעוץ פיננסי"), ו-(2) קלוד מחלק את התסריט לסגמנטים קצרים. קל יותר לרנדר אותם, לתקן אותם ולהלביש עליהם גרפיקה.

PROMPT · SCRIPT + SEGMENTS
Write a 60-second YouTube script for a faceless explainer channel presented by "Maya", an openly AI-generated presenter (she never claims to be a human expert).
Topic: [why the Roman concrete lasted 2,000 years]
Format:
- HOOK (1 sentence, under 12 words)
- 6 SEGMENTS, each 1-2 short spoken sentences (max 25 words), written to be read aloud
- END LINE that invites viewers to subscribe
Also give me:
- a CHAPTER title (max 4 words) for every segment
- one LOWER-THIRD text for the presenter
- FACT-CHECK: every factual claim in the script, with the type of source I should verify it against
Under 130 words of spoken text in total. No medical, legal or financial advice.

בעברית: הוק, 6 סגמנטים קצרים, שורת סיום, כותרות פרקים, כתובית תחתונה, ורשימת עובדות לבדיקה. את הנושא בסוגריים מחליפים.

רשימת ה-FACT-CHECK היא לא קישוט. ערוץ חדשות/הסברים שמפרסם טעויות מאבד אמון מהר, וקלוד יכול לטעות. בודקים כל עובדה לפני שמקליטים.
מה יוצא מהשלב?תסריט של כ-130 מילים מחולק ל-8 קטעים (הוק + 6 + סיום), כותרות פרקים ורשימת בדיקה. אפשר להדביק אותו לחדר הבקרה למטה.
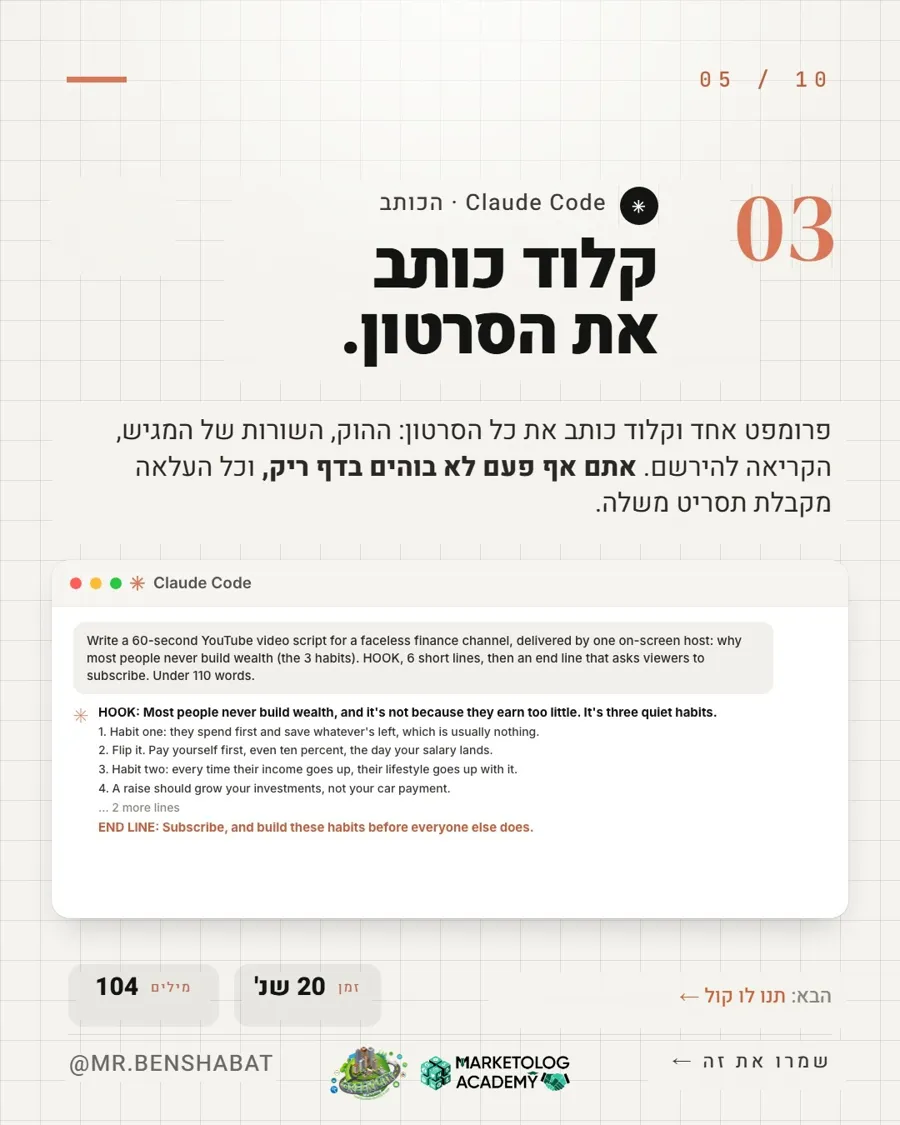
שקופית 5 מהפוסט: קלוד כותב את הסרטון, תסריט ל-60 שניות
מהפוסט: תסריט של 60 שניות לערוץ פיננסים. שימו לב לאזהרת המדיניות בבדיקת העובדות למעלה.
04
SEGMENT 4/7 · כל סרטון

נותנים לו קול

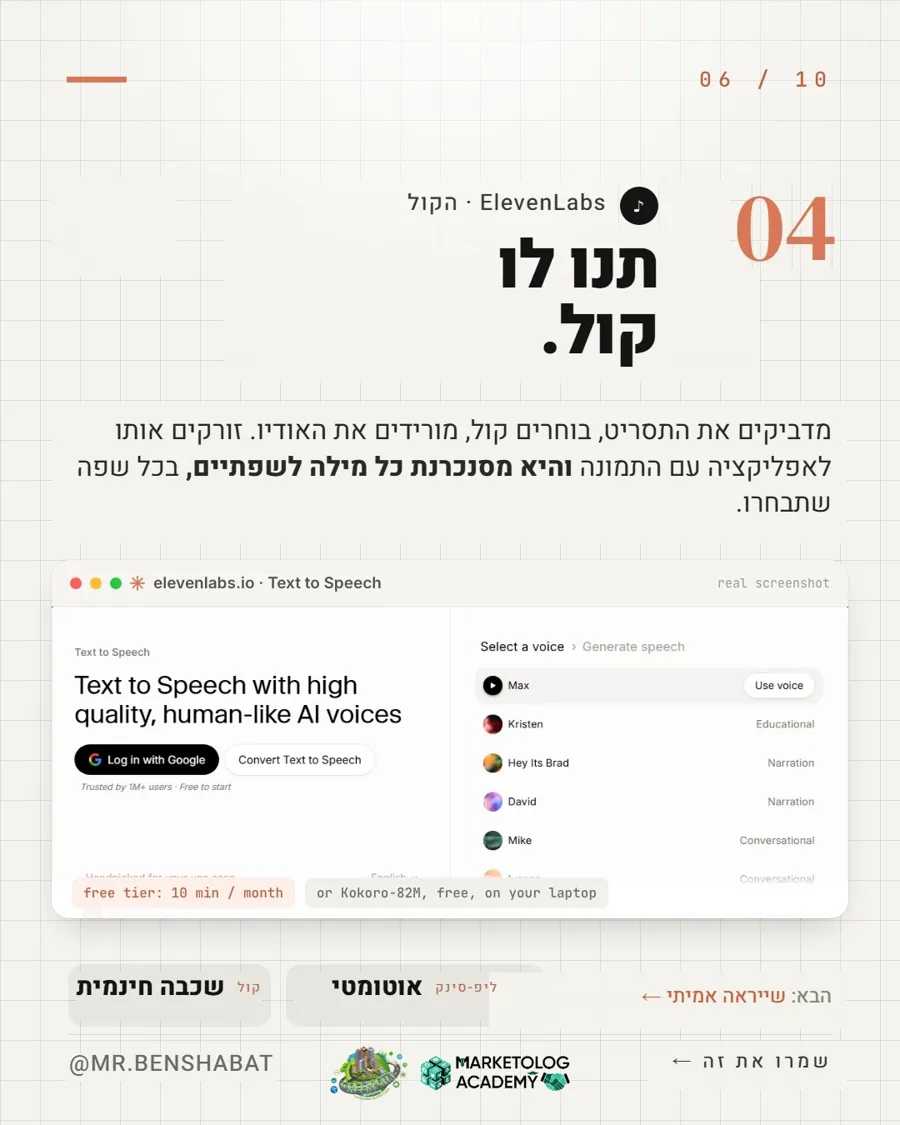
אפשרות א, ElevenLabs: בדף Text to Speech מדביקים סגמנט, בוחרים קול מהספרייה ומורידים MP3. לפי דף העזרה של ElevenLabs, מודל v3 תומך גם בעברית.

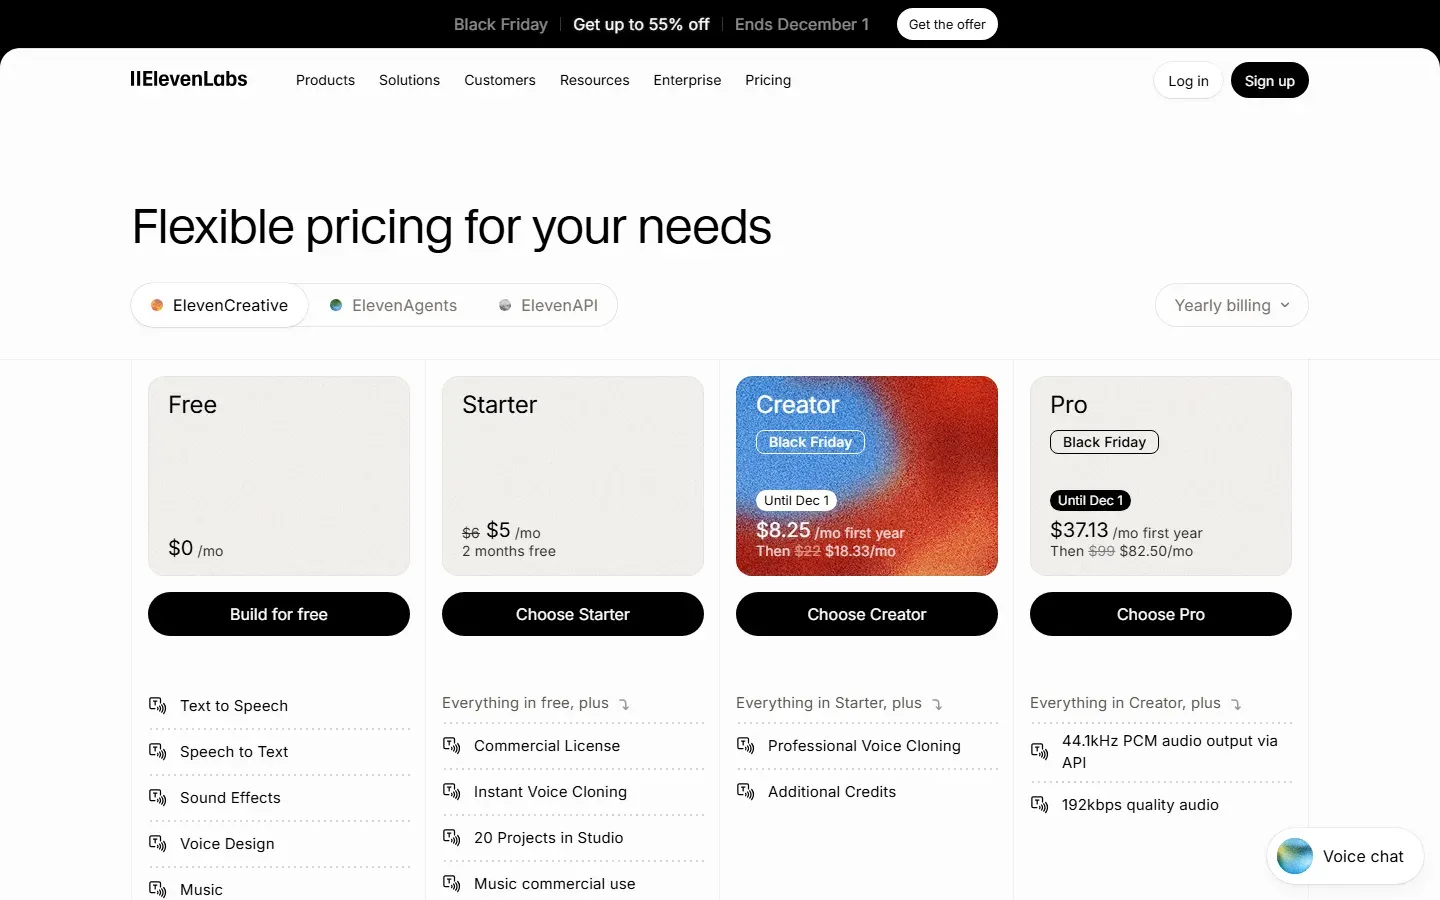
  • Free: ‏10,000 קרדיטים בחודש (בערך 10 דקות), בלי רישיון מסחרי. מתאים לניסיון בלבד.
  • Starter: ‏$6 לחודש במחירון (בזמן הצילום: מבצע Black Friday), כולל Commercial License ו-Instant Voice Cloning.
  • אודיו שנוצר בתוכנית החינמית לא הופך למסחרי אחרי שדרוג. אחרי ששודרגתם, מייצרים מחדש.

אפשרות ב, Kokoro-82M (חינם, מקומי): מודל TTS קטן ברישיון Apache 2.0. לא ראינו תמיכה בעברית, אז זו אפשרות לערוץ באנגלית.

PYTHON · KOKORO
pip install "kokoro>=0.9.2" soundfile
# Linux / Colab also: apt-get -qq -y install espeak-ng

from kokoro import KPipeline
import soundfile as sf
text = open("seg01.txt", encoding="utf-8").read()
pipeline = KPipeline(lang_code='a')          # 'a' = American English
for i, (gs, ps, audio) in enumerate(pipeline(text, voice='af_heart')):
    sf.write(f'seg01_{i}.wav', audio, 24000)

אפשרות ג: ב-WanGP עצמו יש מודלי דיבור (Qwen3 TTS, OmniVoice, IndexTTS ועוד).

שכפול קול (Voice Cloning) רק לקול שלכם, או לקול של מי שנתן לכם הסכמה בכתב. גם ElevenLabs כותבים שכדי להשתמש מסחרית בקול משוכפל צריך הרשאה מתאימה, גם בתוכנית בתשלום.
מה יוצא מהשלב?קובץ אודיו לכל סגמנט: seg01.mp3 עד seg08.mp3.
elevenlabs.io/pricing
דף המחירים של ElevenLabs: Free, Starter עם Commercial License, Creator, Pro
המחירון של ElevenLabs (16.11.2026, בזמן מבצע): Commercial License מתחיל ב-Starter.
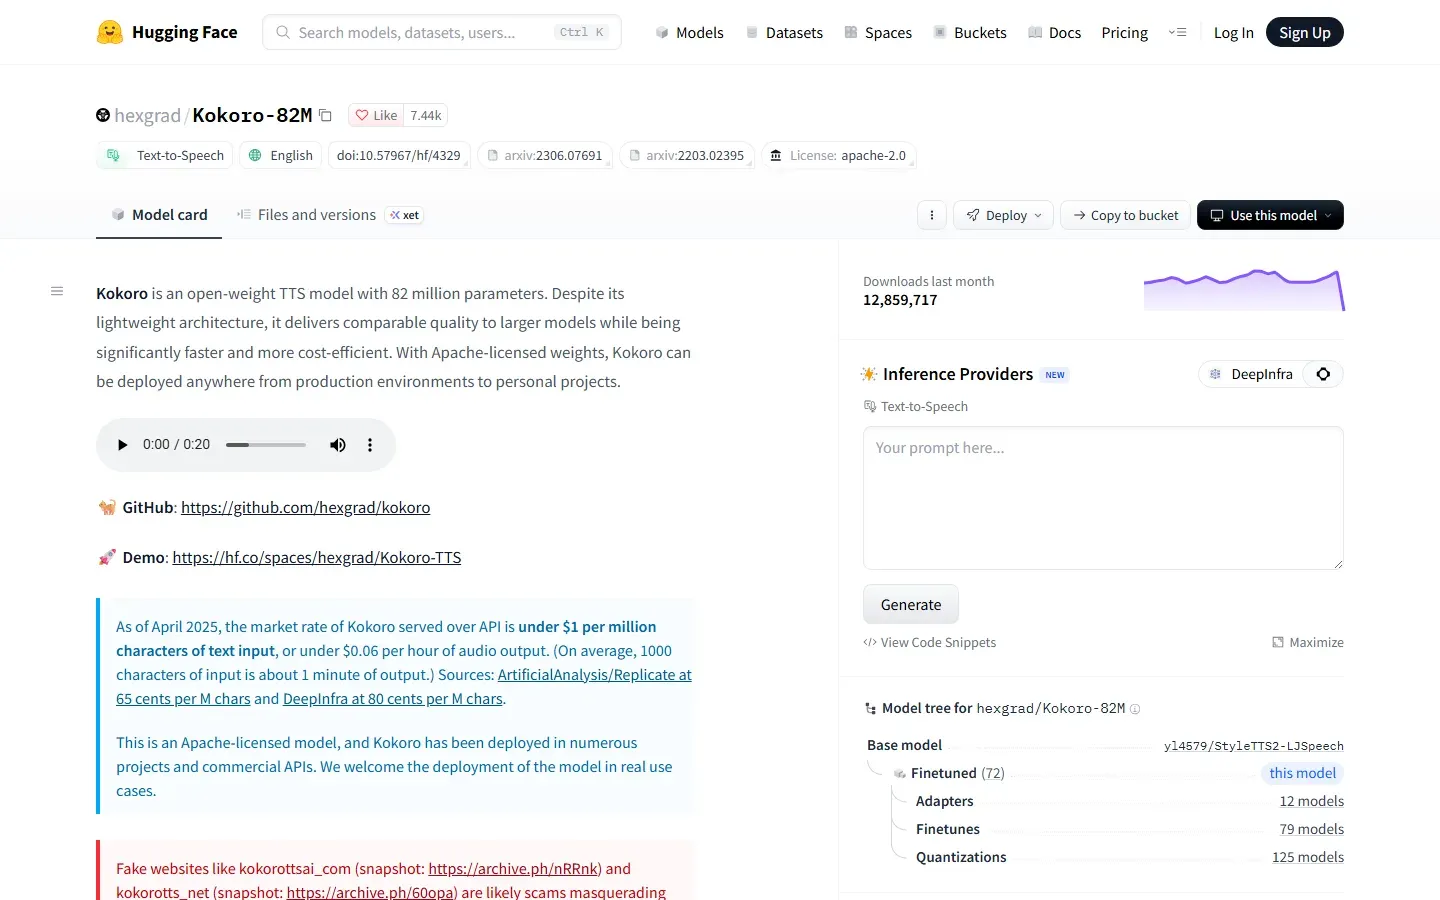
huggingface.co/hexgrad/Kokoro-82M
דף המודל Kokoro-82M ב-Hugging Face, רישיון Apache 2.0
Kokoro-82M: ‏82 מיליון פרמטרים, Apache 2.0.
05
SEGMENT 5/7 · כל סרטון

תמונה + אודיו = מגיש מדבר

  1. ב-WanGP בוחרים את המודל (Hunyuan Video Avatar, או InfiniteTalk / LongCat Avatar 1.5 להשוואה).
  2. מעלים את presenter.png כתמונת הדמות ואת seg01.mp3 כאודיו.
  3. בפרומפט מתארים התנהגות, לא מילים (המילים מגיעות מהאודיו). דוגמה למטה.
  4. Generate. בודקים סנכרון שפתיים, וממשיכים לסגמנט הבא. כשזה עובד, אפשר להכניס את כל הסגמנטים לתור.
PROMPT · PRESENTER BEHAVIOUR
A news presenter speaks directly to the camera in a modern studio, calm confident delivery, subtle natural head movements and blinking, occasional small hand gesture, static medium close-up shot, soft studio lighting.
בהרצה הרשמית (Linux) הקלט הוא קובץ CSV שמצביע על תמונה ואודיו (--input 'assets/test.csv'), והפקודה החסכונית היא hymm_sp/sample_gpu_poor.py עם --use-fp8 --infer-min.
מה יוצא מהשלב?קליפ לכל סגמנט: המגיש מדבר את האודיו, עם הבעות פנים. מחברים אותם לפי הסדר (בעורך או עם ffmpeg).
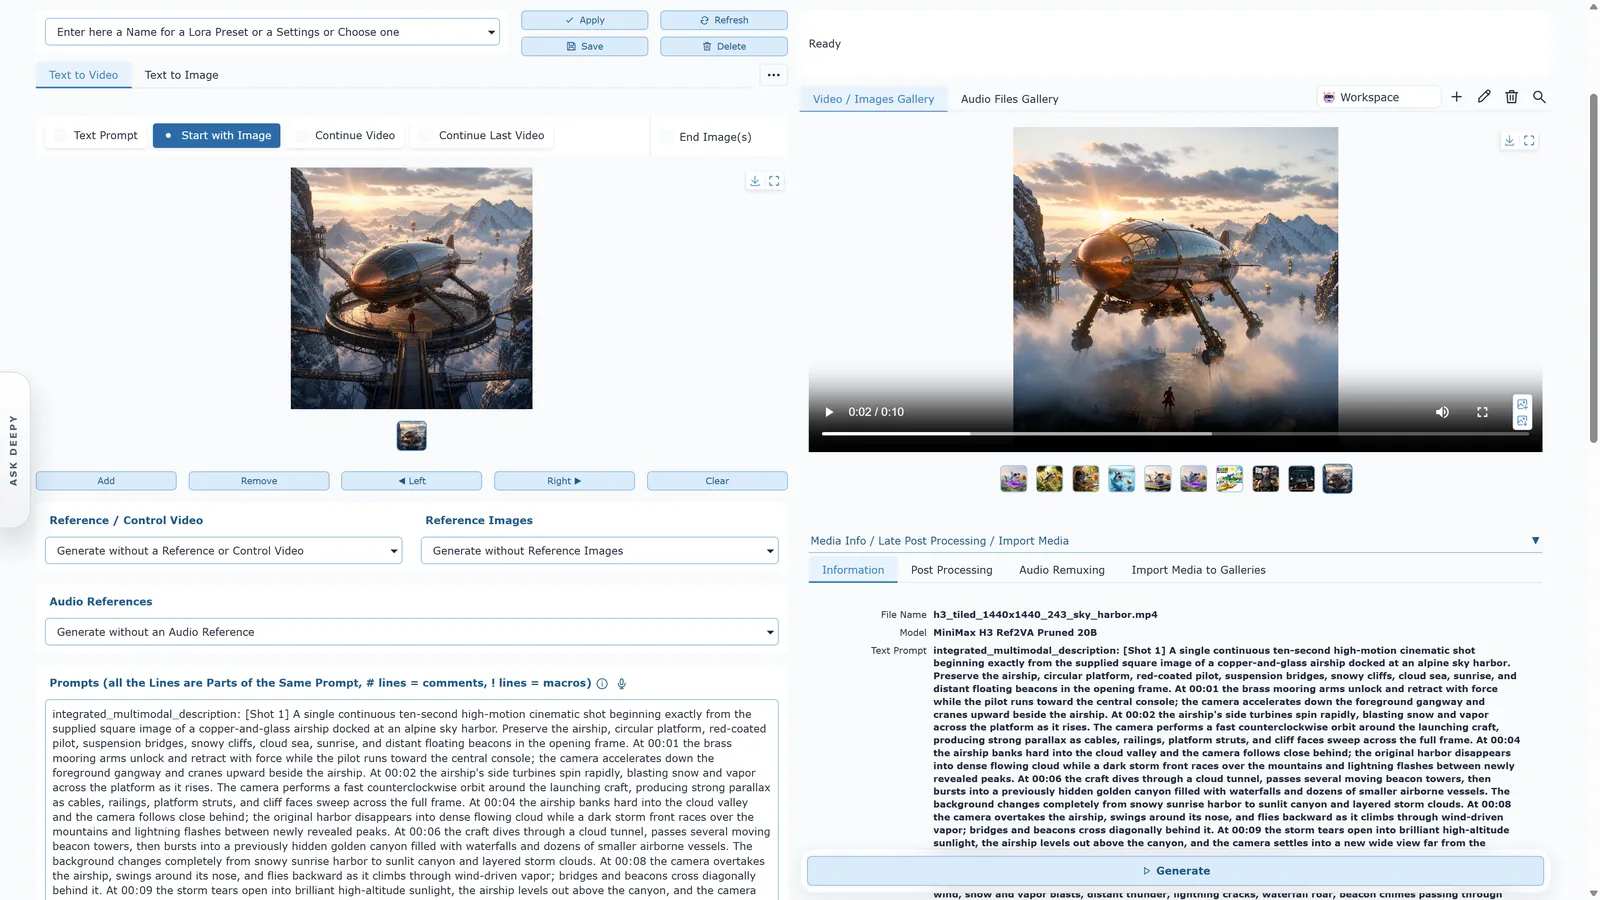
WanGP · ממשק (צילום רשמי מ-wangp.ai)
ממשק WanGP עם Start with Image, Audio References, Prompts ו-Generate
ממשק WanGP. במודלים מבוססי אודיו מעלים תמונה ואודיו, ולוחצים Generate.
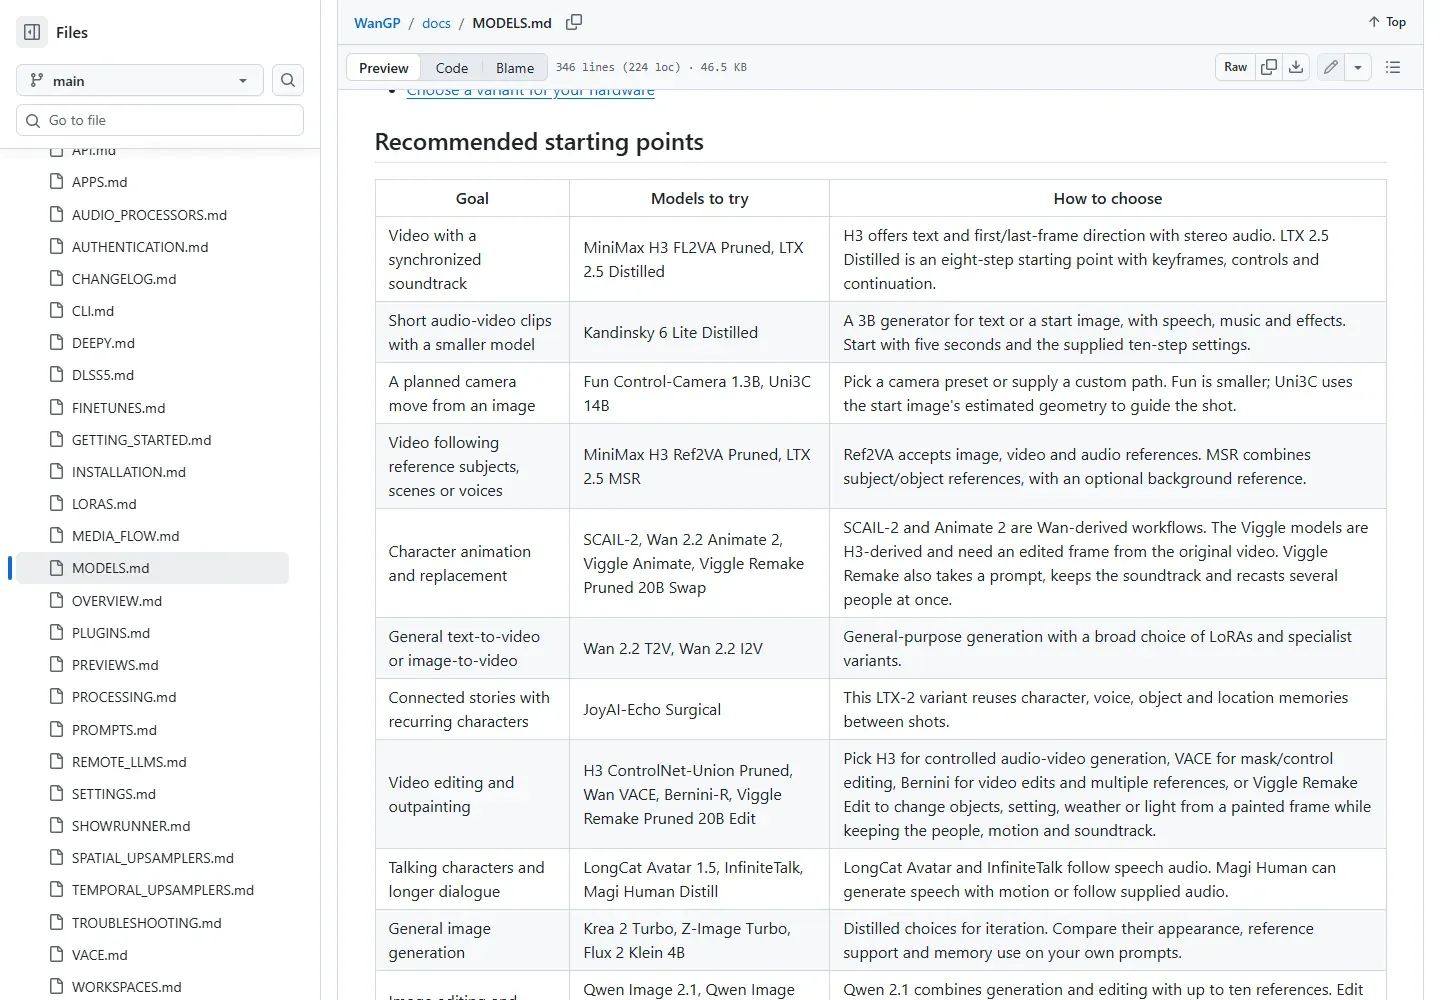
github.com/deepbeepmeep/WanGP/blob/main/docs/MODELS.md
תיעוד המודלים של WanGP: טבלת נקודות פתיחה מומלצות
מדריך המודלים של WanGP: "Talking characters and longer dialogue" (LongCat Avatar, InfiniteTalk ועוד).
06
SEGMENT 6/7 · כל סרטון

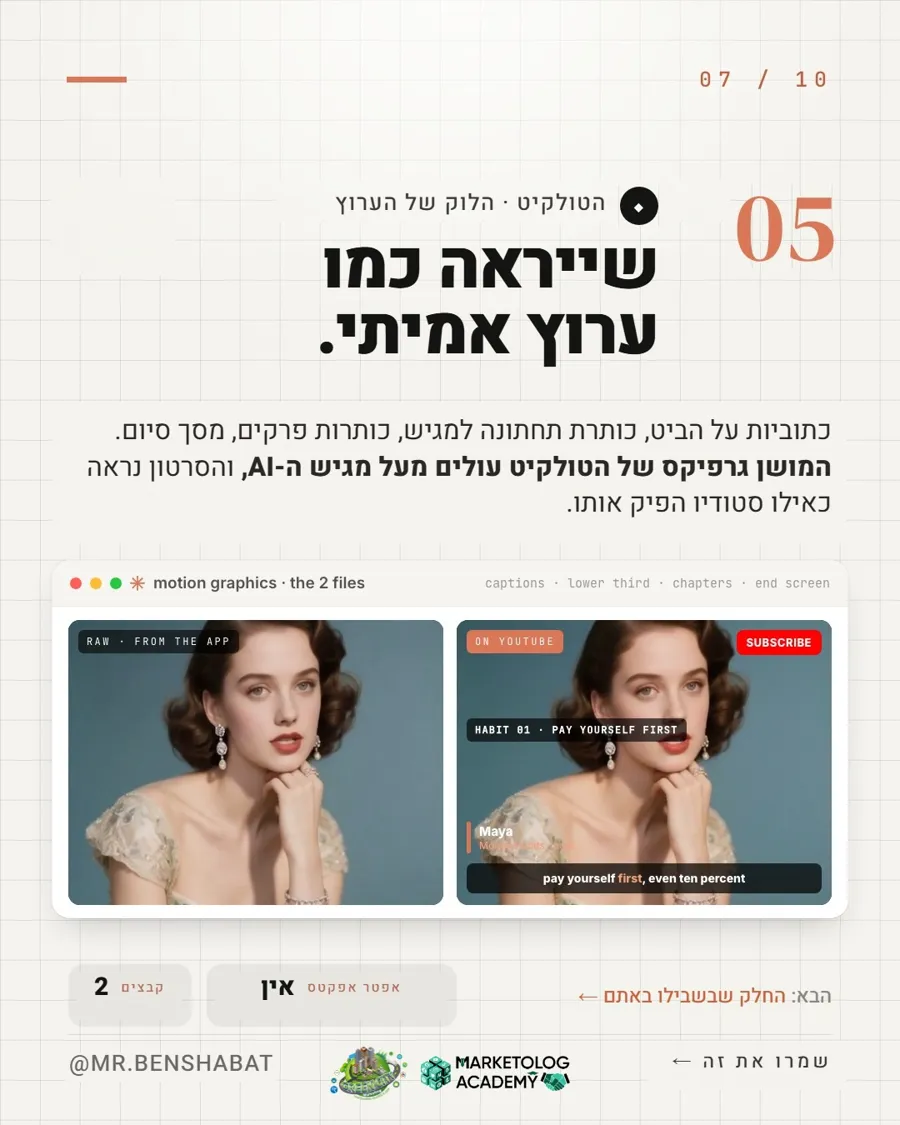
שייראה כמו ערוץ אמיתי: הגרפיקה

מגיש מדבר על רקע ריק נראה כמו דמו. מה שהופך את זה ל"ערוץ" הוא החבילה הגרפית, וכאן נכנסת ההכנסה השנייה מהפוסט, מושן גרפיקס:

  • כתוביות שמסונכרנות למילים, עם הדגשה של מילת מפתח.
  • Lower third: שם המגיש, ולמעלה "AI presenter".
  • כותרות פרקים (Chapters) מהתסריט, וגם בתיאור הסרטון.
  • מסך סיום שמפנה לסרטון הבא.

נסו את כל זה עכשיו בחדר הבקרה ממש מתחת, עם התמונה והתסריט שלכם.

מה יוצא מהשלב?סרטון עם שפה גרפית קבועה, שנראה כמו תוכנית ולא כמו קליפ.
שקופית 7 מהפוסט: לפני ואחרי, מגישה גולמית מול גרסה עם כתוביות, כתובית תחתונה וכותרת פרק
מהפוסט: גולמי מהאפליקציה מול "על יוטיוב". אותה תמונה, עם חבילה גרפית.

Control room

חדר הבקרה

הדביקו תסריט, העלו תמונה (היא נשארת בדפדפן ולא נשלחת לשום מקום), ולחצו "שידור". החדר מחלק לסגמנטים, מעריך משך ומריץ כתוביות, כותרת תחתונה ופרקים. המחשה אין כאן סנכרון שפתיים. את זה עושה HunyuanVideo-Avatar. כאן רואים איך החבילה הגרפית תיראה.

Altered or synthetic content
ON AIR00:00
CH 00 · STANDBY
מאיה · מגישה וירטואליתAI PRESENTER · NOT A REAL PERSON

RUNDOWN INPUT

0מילים
0sמשך משוער*
0סגמנטים

    *לפי קצב קריינות של כ-150 מילים לדקה. זו הערכה, האורך האמיתי נקבע לפי האודיו.

    סגמנטים להעתקה (אחד לכל קובץ אודיו)
    07
    SEGMENT 7/7 · כל סרטון

    מעלים, ומסמנים גילוי AI

    1. YouTube Studio ← Create ← Upload videos.
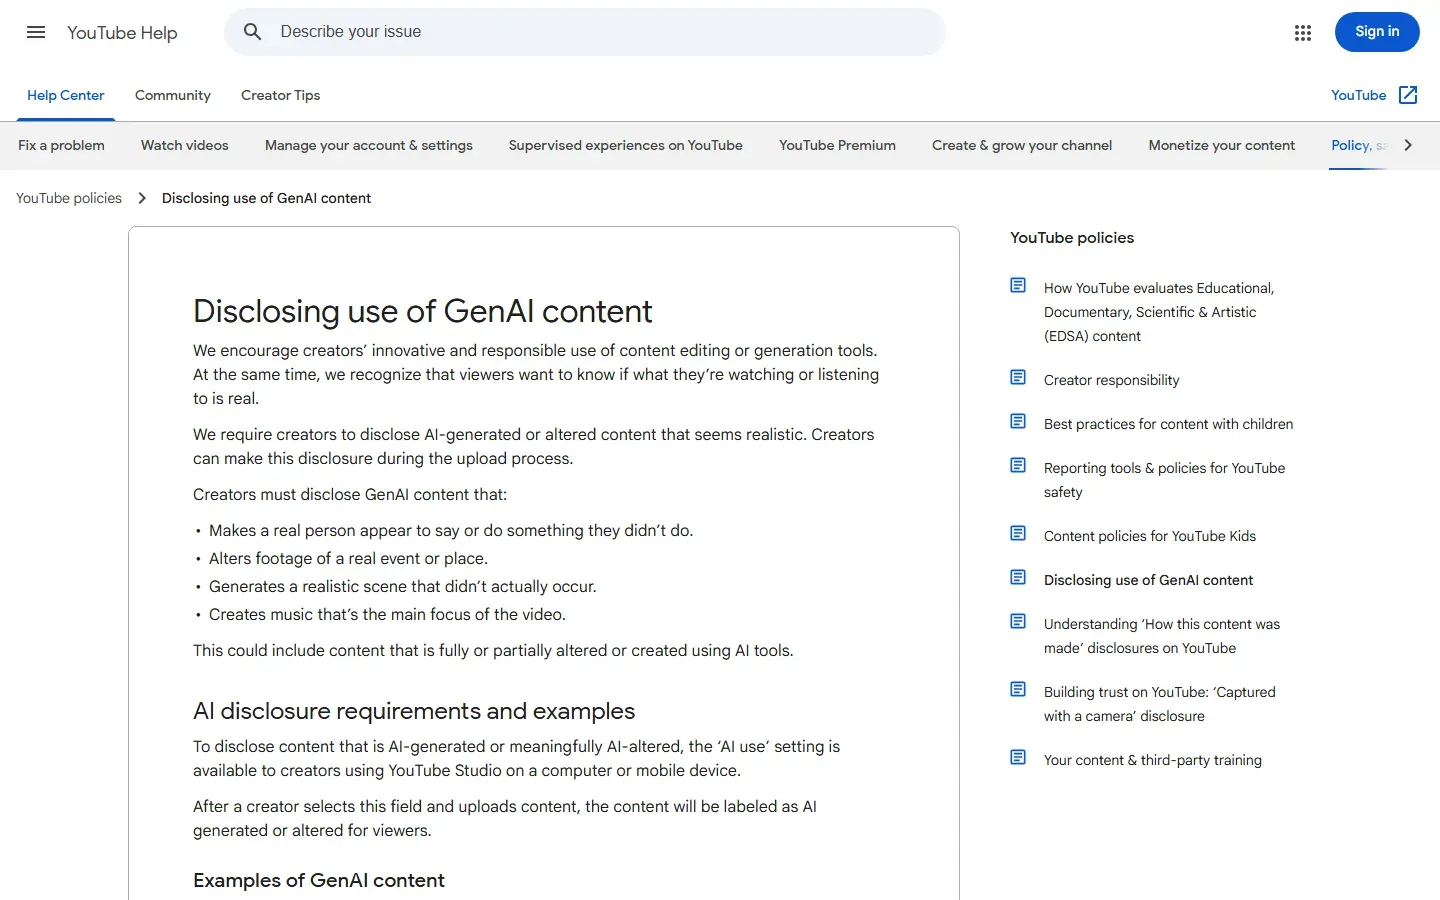
    2. באזור Attributes, תחת AI use: מגיש פוטוריאליסטי שלא קיים = סצנה מציאותית שלא קרתה, אז מסמנים Yes. (מגיש מצויר בבירור לא מחייב גילוי.)
    3. בתיאור: שורה כנה כמו "המגישה בסרטון נוצרה ב-AI. התוכן נבדק ונערך על ידי אדם."
    4. Chapters בתיאור (מהתסריט), ומסך סיום.
    לפי יוטיוב: "Disclosing AI content alone won't limit a video's audience or impact its eligibility to earn money". מי שלא מגלה שוב ושוב עלול לקבל תווית ידנית, הסרת תוכן או השעיה מ-YPP.
    מה יוצא מהשלב?סרטון באוויר, מסומן נכון. התווית מופיעה בתיאור המורחב, ובתוכן פוטוריאליסטי לפעמים גם בנגן.
    support.google.com/youtube/answer/14328491
    מרכז העזרה של יוטיוב: Disclosing use of GenAI content
    יוטיוב: "Disclosing use of GenAI content". מתי חייבים לגלות, ואיך.

    Standards & practices

    מדיניות יוטיוב והסכמה

    החלק שהפוסט דילג עליו. מבוסס על דפי העזרה הרשמיים של יוטיוב (נבדק ב-16.11.2026). זה לא ייעוץ משפטי. בעסק אמיתי, התייעצו עם עו"ד.

    1. גילוי תוכן AI (Altered or synthetic)

    חובה לגלות כשהתוכן נראה מציאותי ו:

    • אדם אמיתי נראה אומר או עושה משהו שלא אמר או עשה
    • צילום של אירוע או מקום אמיתי שונה
    • נוצרה סצנה מציאותית שלא קרתה
    • מוזיקה שנוצרה ב-AI היא מרכז הסרטון

    לא חובה: תוכן לא מציאותי, פילטרים ותיקוני צבע, שימוש ב-AI לתסריט, לסקיצה או לתמונה ממוזערת, אנימציה מלאה, שכפול הקול שלכם לקריינות.

    2. מה לא מקבל מונטיזציה

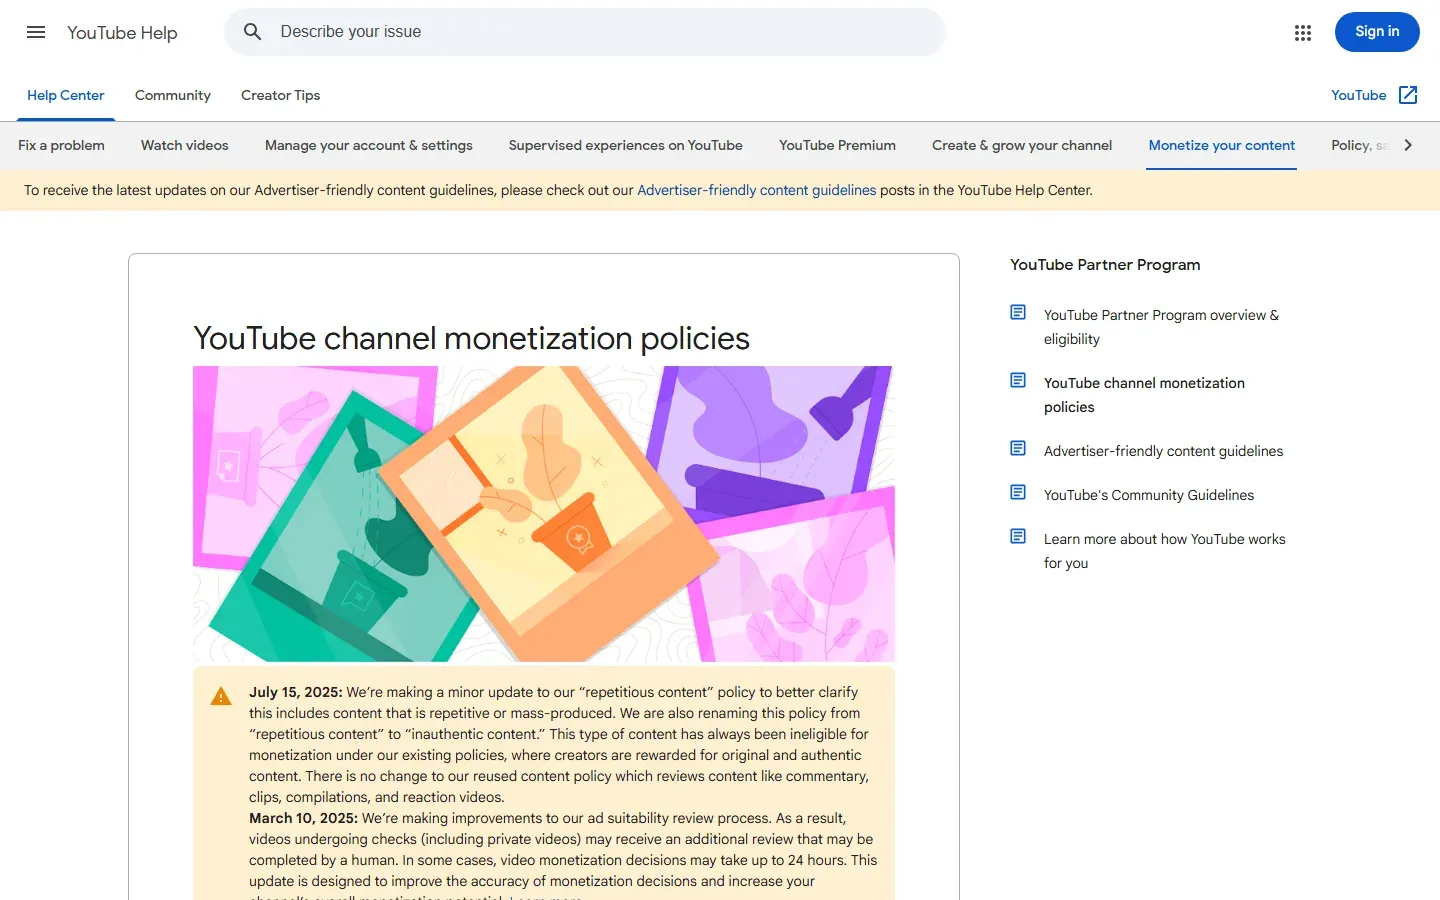
    • Inauthentic content (השם מ-15.7.2025): תוכן חוזר או מתבנית, כולל תוכן AI מתבניות גנריות "שנותן רושם של ייצור המוני".
    • פרסונות AI על נושאים רגישים: ערוצים שבהם פרסונת AI מוצגת כמומחה אנושי בבריאות, משפט, כספים או פוליטיקה. הדוגמאות של יוטיוב: "רופא" AI שנותן אבחנות, ומגישי פודקאסט AI שנותנים ייעוץ פיננסי.
    • Reused content: תוכן של אחרים בלי שינוי מהותי, גם אם קיבלתם רשות.

    מה כן: AI שמשרת חזון יצירתי שלכם, עם ערך חינוכי או בידורי ממשי.

    3. פנים וקול של אדם אמיתי

    • מי שמזהה את הפנים או הקול שלו בסרטון AI יכול להגיש ליוטיוב תלונת פרטיות. למעלה יש 48 שעות להסיר את התוכן, ואחר כך יוטיוב בודק בעצמו.
    • בבדיקה יוטיוב שוקל אם אפשר לטעות ולחשוב שזה אמיתי, אם האדם מזוהה, אם יש גילוי AI, ואם זו סאטירה.
    • אל תבחרו פנים "בהשראת" סלב, ואל תשכפלו קול של אדם אחר בלי הסכמה כתובה.

    4. רישיונות הכלים

    • HunyuanVideo-Avatar: הרישיון לא חל באיחוד האירופי, בבריטניה ובדרום קוריאה. מעל 100 מיליון משתמשים חודשיים צריך רישיון מ-Tencent. Tencent לא תובעת זכויות על התוצרים.
    • ElevenLabs Free: לא מסחרי. ערוץ ממונטז = תוכנית בתשלום.
    • Kokoro-82M: ‏Apache 2.0.
    • WanGP: מותר למכור תוצרים. קרדיט נדרש רק במכירה ישירה של תוצר.
    support.google.com/youtube/answer/1311392
    מדיניות המונטיזציה של יוטיוב: הודעה על inauthentic content
    YouTube channel monetization policies: ההודעה מ-15.7.2025 על שינוי השם ל-"inauthentic content".

    Ratings

    ככה זה משלם, בלי סיפורים

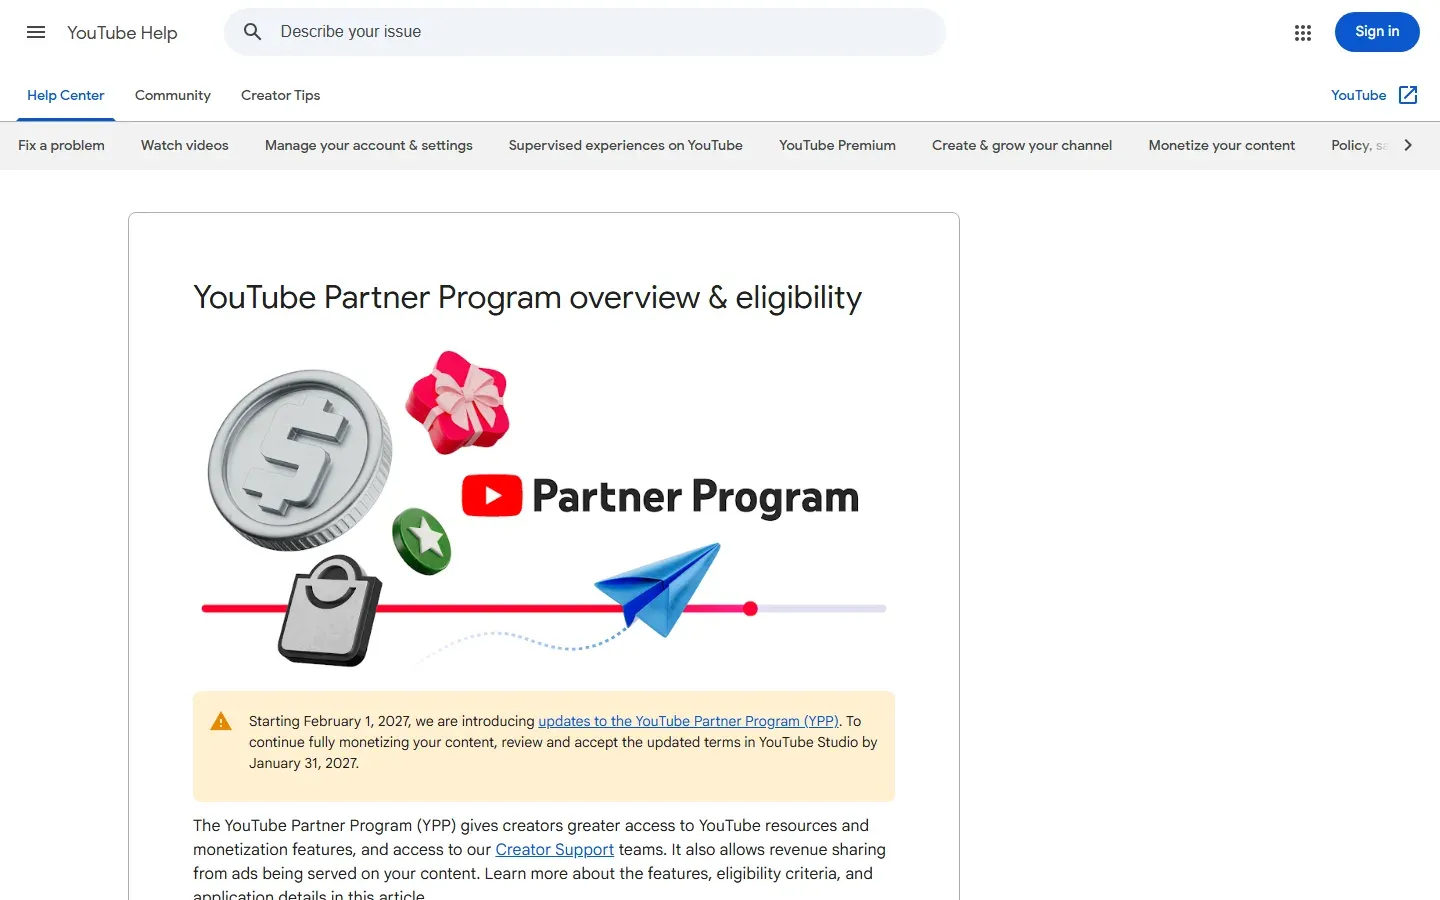
    כדי להצטרף לתוכנית השותפים (YPP) צריך 1,000 מנויים, ובנוסף אחד משניים: 4,000 שעות צפייה ציבוריות בסרטונים ארוכים ב-12 החודשים האחרונים, או 10 מיליון צפיות Shorts ב-90 הימים האחרונים. ישראל ברשימת המדינות הזמינות.

    שקופית 8 בפוסט מחשבת $28K-$57K לפי "$2-4 לאלף צפיות" בסרטונים ארוכים. זה אומדן של היוצר, לא נתון שלכם. ה-RPM בפועל תלוי בנישה, במדינת הצופים ובאורך הסרטון, ורואים אותו רק אחרי הקבלה, ב-YouTube Studio ← Analytics ← Revenue.

    המסקנה המעשית: ערוץ מגיש AI מרוויח כשהוא נותן ערך אמיתי (הסבר, מחקר, סיפור) בנישה שלא נחשבת "ייעוץ מומחה", עם גילוי AI ובדיקת עובדות.
    support.google.com/youtube/answer/72851
    מרכז העזרה של יוטיוב: YouTube Partner Program overview & eligibility
    YouTube Partner Program overview & eligibility.

    Second income

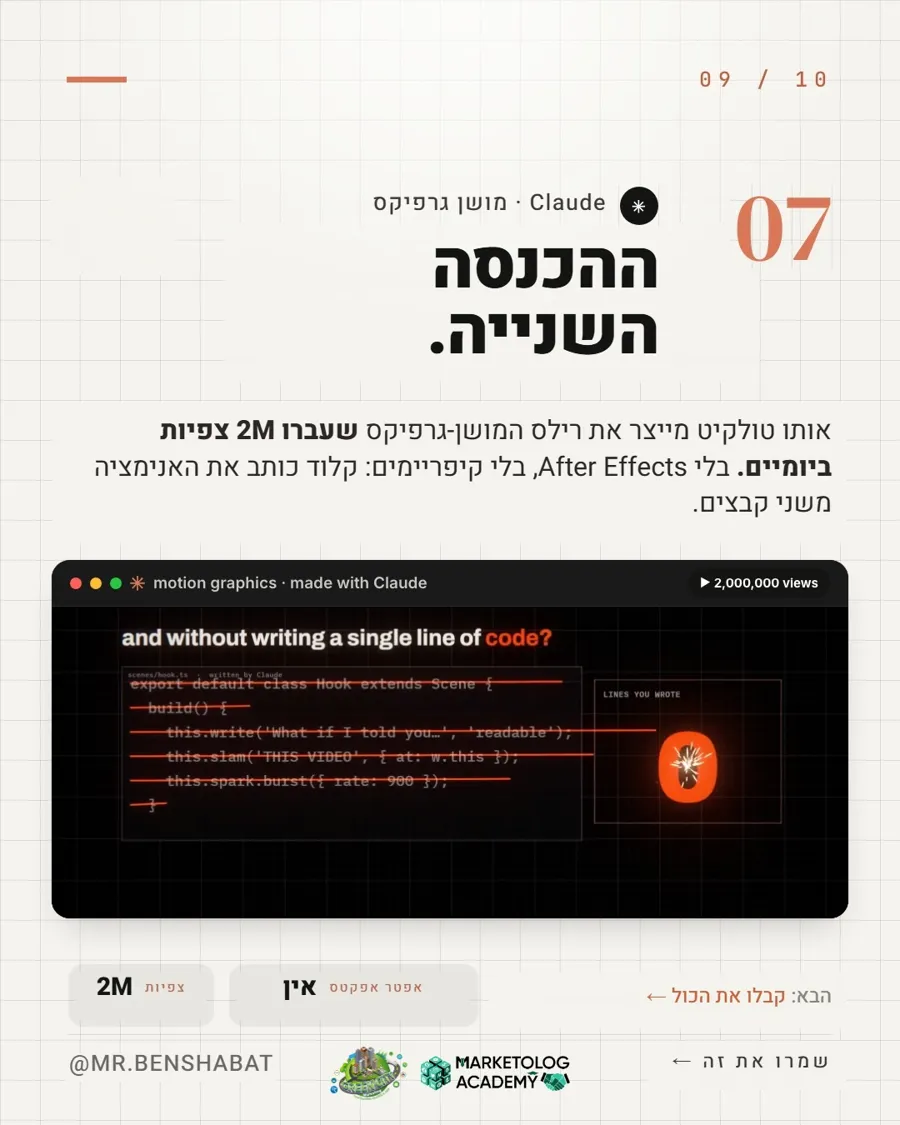
    ההכנסה השנייה: מושן גרפיקס

    החבילה הגרפית מסגמנט 6 היא גם שירות שאפשר למכור: סרטוני מושן לעסקים וליוצרים, בלי After Effects. Claude Code כותב את האנימציה כקוד משני קבצים (פרויקט ZIP ומדריך PDF), ואתם מתארים במילים מה קורה:

    1. מעלים ל-Claude Code את שני הקבצים, והוא מקים את הפרויקט.
    2. כותבים קודם את ההוק של 3 השניות הראשונות.
    3. קריינות (ElevenLabs), וקלוד מסנכרן כל אנימציה למילים.
    4. מתארים, לא מנפישים. אחר כך עריכה, סאונד ורינדור.

    "2M צפיות ביומיים" הוא נתון מהפוסט. לא אימתנו אותו.

    שקופית 9 מהפוסט: ההכנסה השנייה, מושן גרפיקס שקלוד כתב

    Equipment

    הציוד, חינם מול בתשלום

    כליתפקידמחיר / רישיוןקישור
    HunyuanVideo-Avatarתמונה + אודיו = מגיש מדברחינם, Tencent Hunyuan Community License (לא באיחוד האירופי, בבריטניה ובדרום קוריאה)GitHub ↗
    WanGPמריץ את Hunyuan Avatar ב-10GB, ועוד מודלי מגישים ו-TTSחינם להרצה מקומית (WanGP Community License 2.0)GitHub ↗
    Claudeתסריט, סגמנטים, כותרות, בדיקת עובדותFree / Pro ‏$17 בתשלום שנתי, $20 חודשיclaude.com ↗
    ElevenLabsקריינות (כולל עברית ב-v3)Free ‏10K קרדיטים (לא מסחרי) · Starter ‏$6 עם Commercial Licensepricing ↗
    Kokoro-82Mקריינות מקומית חינמיתApache 2.0 (ללא עברית)Hugging Face ↗
    YouTube Studioהעלאה, AI use, Chapters, אנליטיקסחינםstudio.youtube.com ↗
    hunyuanvideo-avatar.github.io
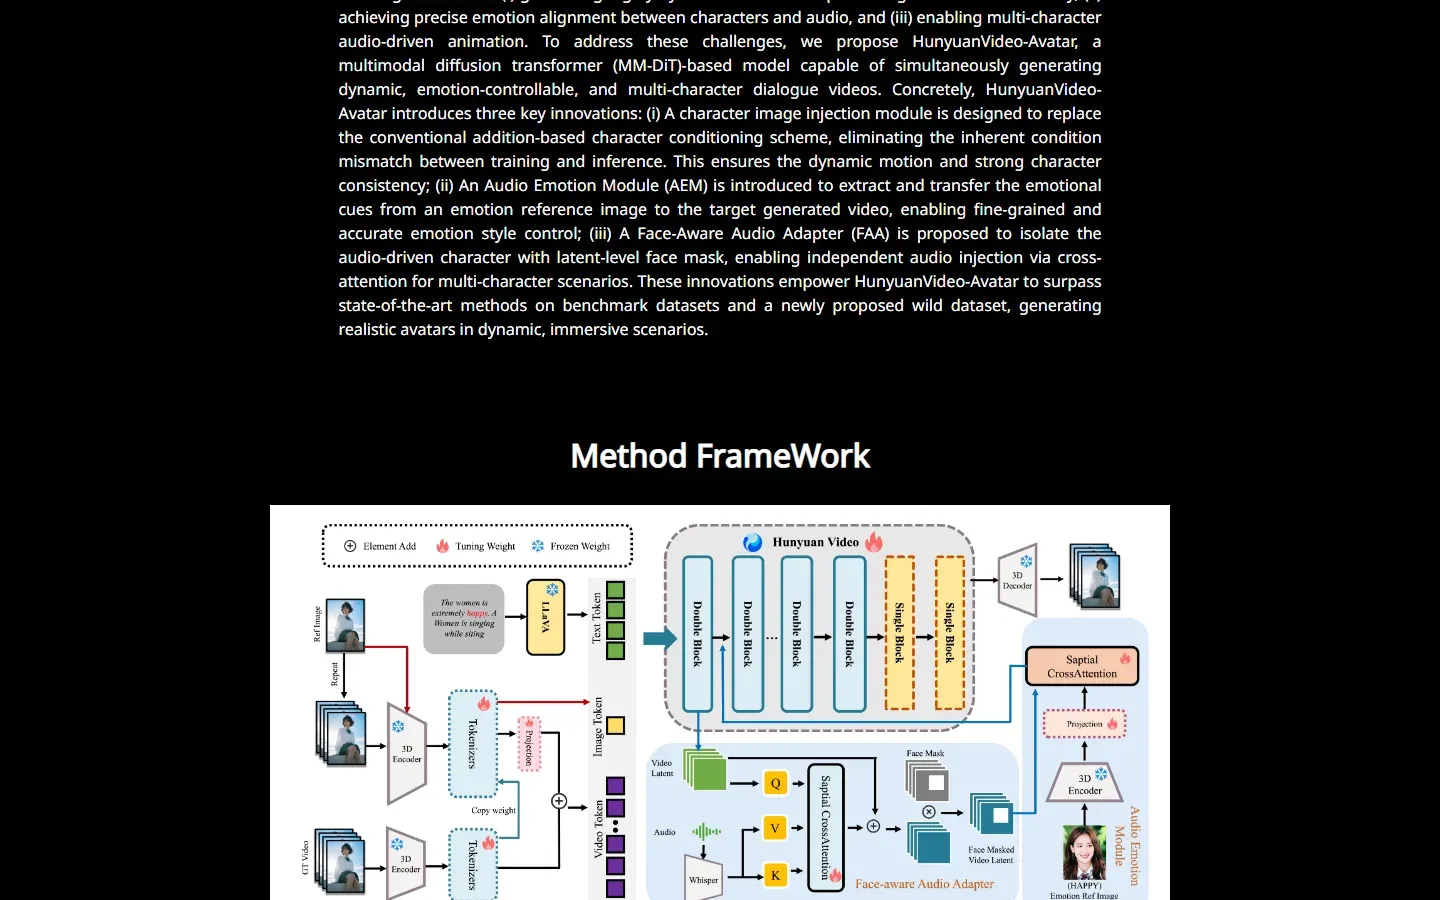
    דף הפרויקט של HunyuanVideo-Avatar: תקציר ותרשים השיטה
    דף הפרויקט הרשמי: תקציר ותרשים השיטה (MM-DiT, הזרקת דמות, מודול רגש).

    Technical difficulties

    תקלות בשידור

    👄 השפתיים לא מסונכרנות

    תמונה עם פה סגור ופנים ישר למצלמה, אודיו נקי בלי מוזיקה ברקע, וסגמנטים קצרים. את המוזיקה מוסיפים בעריכה, לא באודיו שנכנס למודל.

    💥 Out of memory

    ב-WanGP: רזולוציה נמוכה יותר, פרופיל זיכרון חסכוני, ודפדפן בלי GPU. בהרצה הרשמית: --cpu-offload או --infer-min.

    🎭 המגיש "זז" מדי או קפוא

    מכוונים את פרומפט ההתנהגות (static medium close-up, subtle head movements). ואם המודל הזה לא מתאים, משווים מול InfiniteTalk או LongCat Avatar ב-WanGP.

    🔇 ElevenLabs חסם הורדה

    נגמרו הקרדיטים החודשיים (אין צבירה ב-Free). מחכים לחודש הבא, משדרגים, או עוברים ל-Kokoro.

    🚫 "Limited or no ads"

    בודקים נישה (לא ייעוץ פיננסי/רפואי), גיוון בין סרטונים, וסימון AI use. "תבנית" זהה בכל סרטון = inauthentic content.

    ⚖️ פנייה על דמיון לאדם

    מסירים מיד (תוך 48 שעות לפי התהליך של יוטיוב), מחליפים פנים, ובפעם הבאה מייצרים מגיש בדיוני ומתעדים את הפרומפט.

    Archive

    השקופיות המקוריות

    גללו הצידה. לחיצה מגדילה.

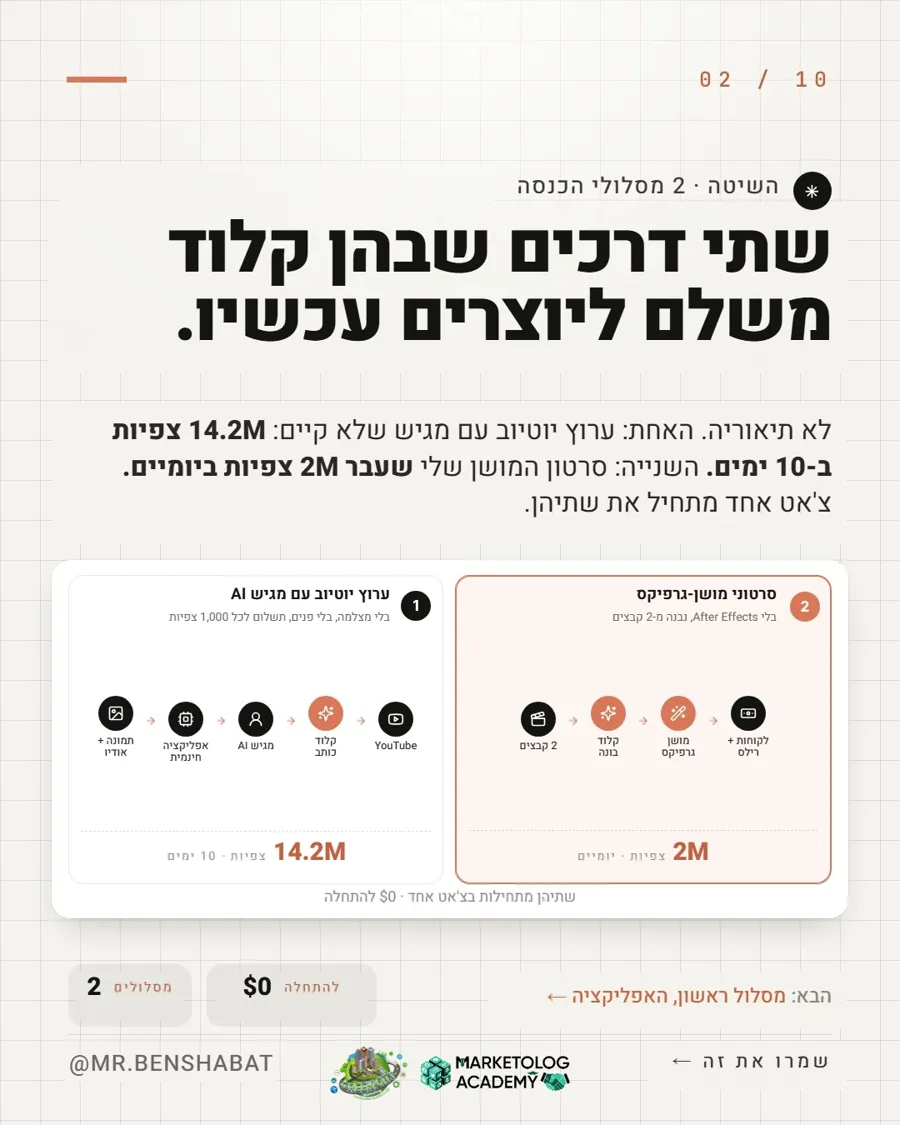
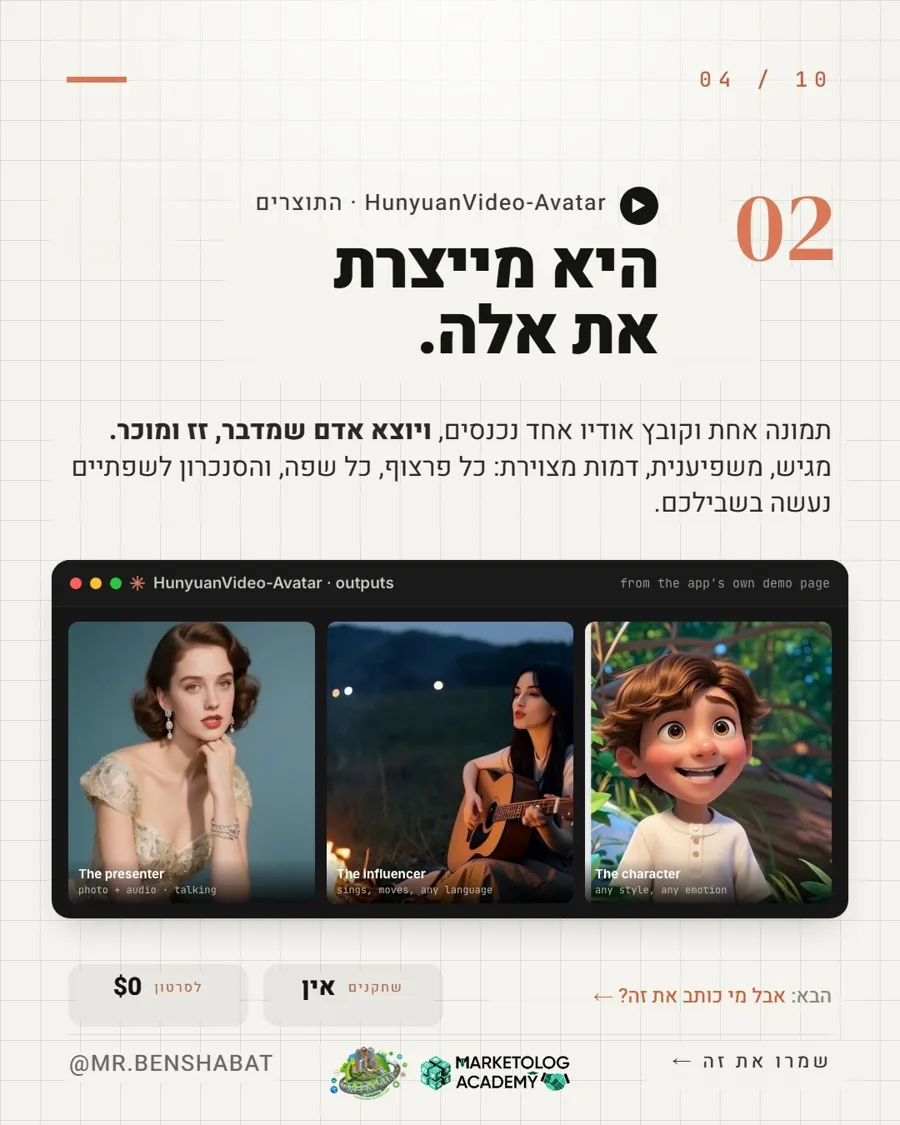
    שקופית 1: קלוד נתפס מריץ 11 ערוצי יוטיוב במקביל שקופית 2: שתי דרכים שבהן קלוד משלם ליוצרים שקופית 3: תורידו את האפליקציה HunyuanVideo-Avatar שקופית 4: היא מייצרת את אלה שקופית 5: קלוד כותב את הסרטון שקופית 6: תנו לו קול, ElevenLabs שקופית 7: שייראה כמו ערוץ אמיתי שקופית 8: ככה זה משלם שקופית 9: ההכנסה השנייה

    Q&A

    שאלות מהקהל

    זה באמת "חינם לתמיד"?

    המודל והתוכנה חינמיים. החומרה, החשמל והקול המסחרי עולים כסף. בלי GPU מתאים משלמים על שרת. לערוץ ממונטז עם ElevenLabs צריך תוכנית בתשלום.

    אפשר מגיש שמדבר עברית?

    כן, דרך הקול: ElevenLabs v3 תומך בעברית לפי דף העזרה שלהם, ו-HunyuanVideo-Avatar מונע מהאודיו. בדקו את איכות סנכרון השפתיים בעברית בקליף ניסיון לפני שאתם מתחייבים.

    חייבים לסמן AI use?

    מגיש פוטוריאליסטי שלא קיים הוא תוכן מציאותי שנוצר ב-AI, ולכן הכי בטוח לסמן Yes. לפי יוטיוב הגילוי עצמו לא פוגע בחשיפה או בזכאות להכנסה. מגיש מצויר בבירור לא מחייב גילוי.

    אפשר להשתמש בתמונה שלי ובקול שלי?

    כן, וזו האפשרות הכי נקייה. שכפול הקול שלכם לקריינות מופיע אצל יוטיוב כדוגמה למשהו שלא מחייב גילוי. אבל אם הסרטון מראה אתכם אומרים משהו שלא אמרתם בפועל ונראה מציאותי, עדיף לגלות.

    ומה עם ערוץ פיננסים כמו בפוסט?

    מגיש AI שמוצג כמומחה לכסף לא יקבל מונטיזציה לפי מדיניות יוטיוב. אם בכל זאת: מציגים את המגיש בגלוי כ-AI, לא נותנים ייעוץ אישי, מביאים מקורות, ועדיף שאדם אמיתי ומוסמך יחתום על התוכן.

    11 ערוצים במקביל, כמו בכותרת?

    תתחילו בערוץ אחד, עם מגיש אחד ונישה אחת, עד שיש תהליך בדיקה ואיכות. ריבוי ערוצים עם תבנית זהה הוא בדיוק מה שמדיניות ה-inauthentic content מכוונת אליו.

    צ'קליסט לפני עלייה לאוויר

    רוצים עוד מערכות כאלה?

    עקבו אחרי @mr.benshabat

    כל שבוע: מערכות AI, אוטומציות ושיווק דיגיטלי, מוסברים צעד אחר צעד.

    Green City MarketingMarketolog Academy